클로드 오퍼스 5.5 출시, 이제 페이블 안 써도 될까?
값은 절반도 안 되는데 시험은 9개 전부 더 잘 봤습니다. 어제 나온 클로드 오퍼스 5.5 이야기입니다. 원문 수치와 쉬운 말을 나란히 놓고 비교해 드립니다.
페이블 쓰시는 분들이 늘 하시는 말이 있습니다. "좋긴 한데, 너무 비싸요." 저도 같은 고민을 합니다. 그래서 새 모델이 나오면 성능표보다 먼저 묻습니다. 이걸로 바꾸면 돈이 줄어드나, 일은 그대로 되나.
대부분의 일은 오퍼스 5.5로 충분합니다. 다만 페이블이 여전히 필요한 순간이 하나 있습니다. 숫자로 하나씩 보겠습니다.
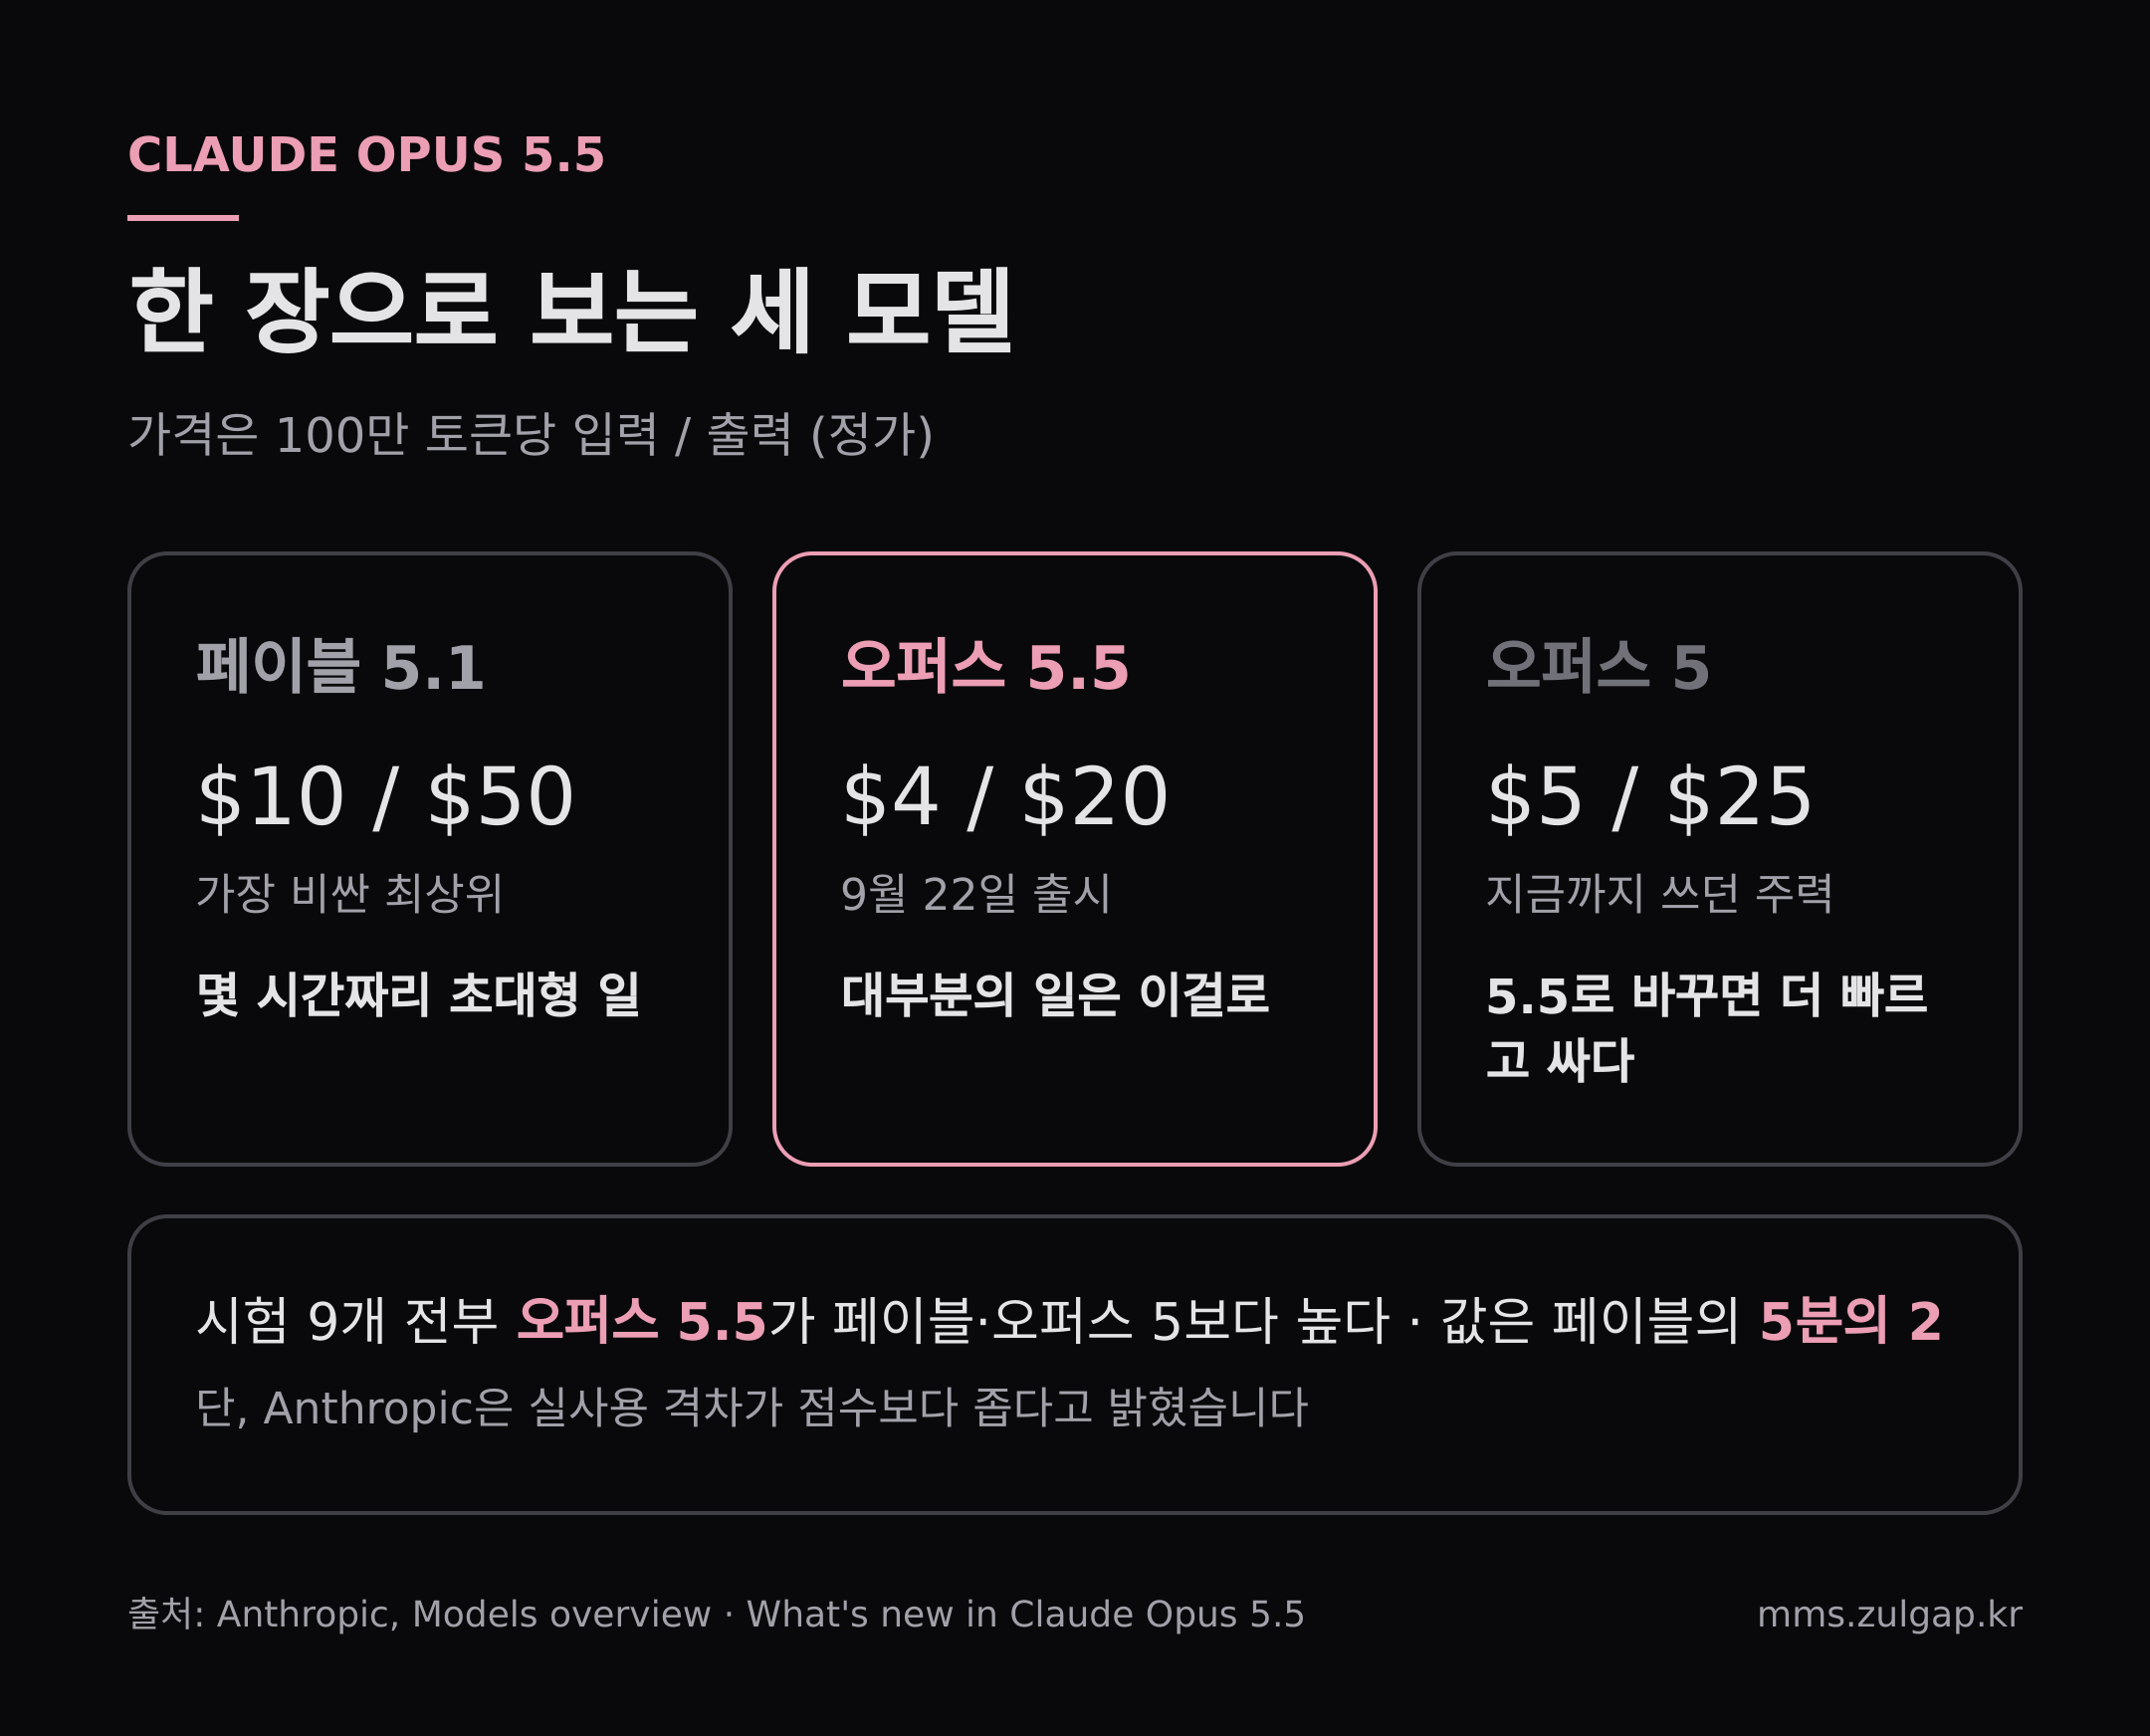
페이블은 얼마나 비쌌나 — 가격부터 나란히
비교의 출발점은 가격입니다. 성능이 비슷하다면 값이 판단을 끝내기 때문입니다.
| 모델 | 입력 (100만 토큰당) | 출력 (100만 토큰당) | 쉽게 말하면 |
|---|---|---|---|
| 페이블 5.1 | $10 | $50 | 가장 비싼 최상위 모델 |
| 오퍼스 5 (이전) | $5 | $25 | 지금까지 쓰던 주력 |
| 오퍼스 5.5 (신규) | $4 | $20 | 페이블의 5분의 2 값 |
📄 원문 · Anthropic 모델 비교표 · Fable 5.1 $10 / $50 · Opus 5.5 $4 / $20
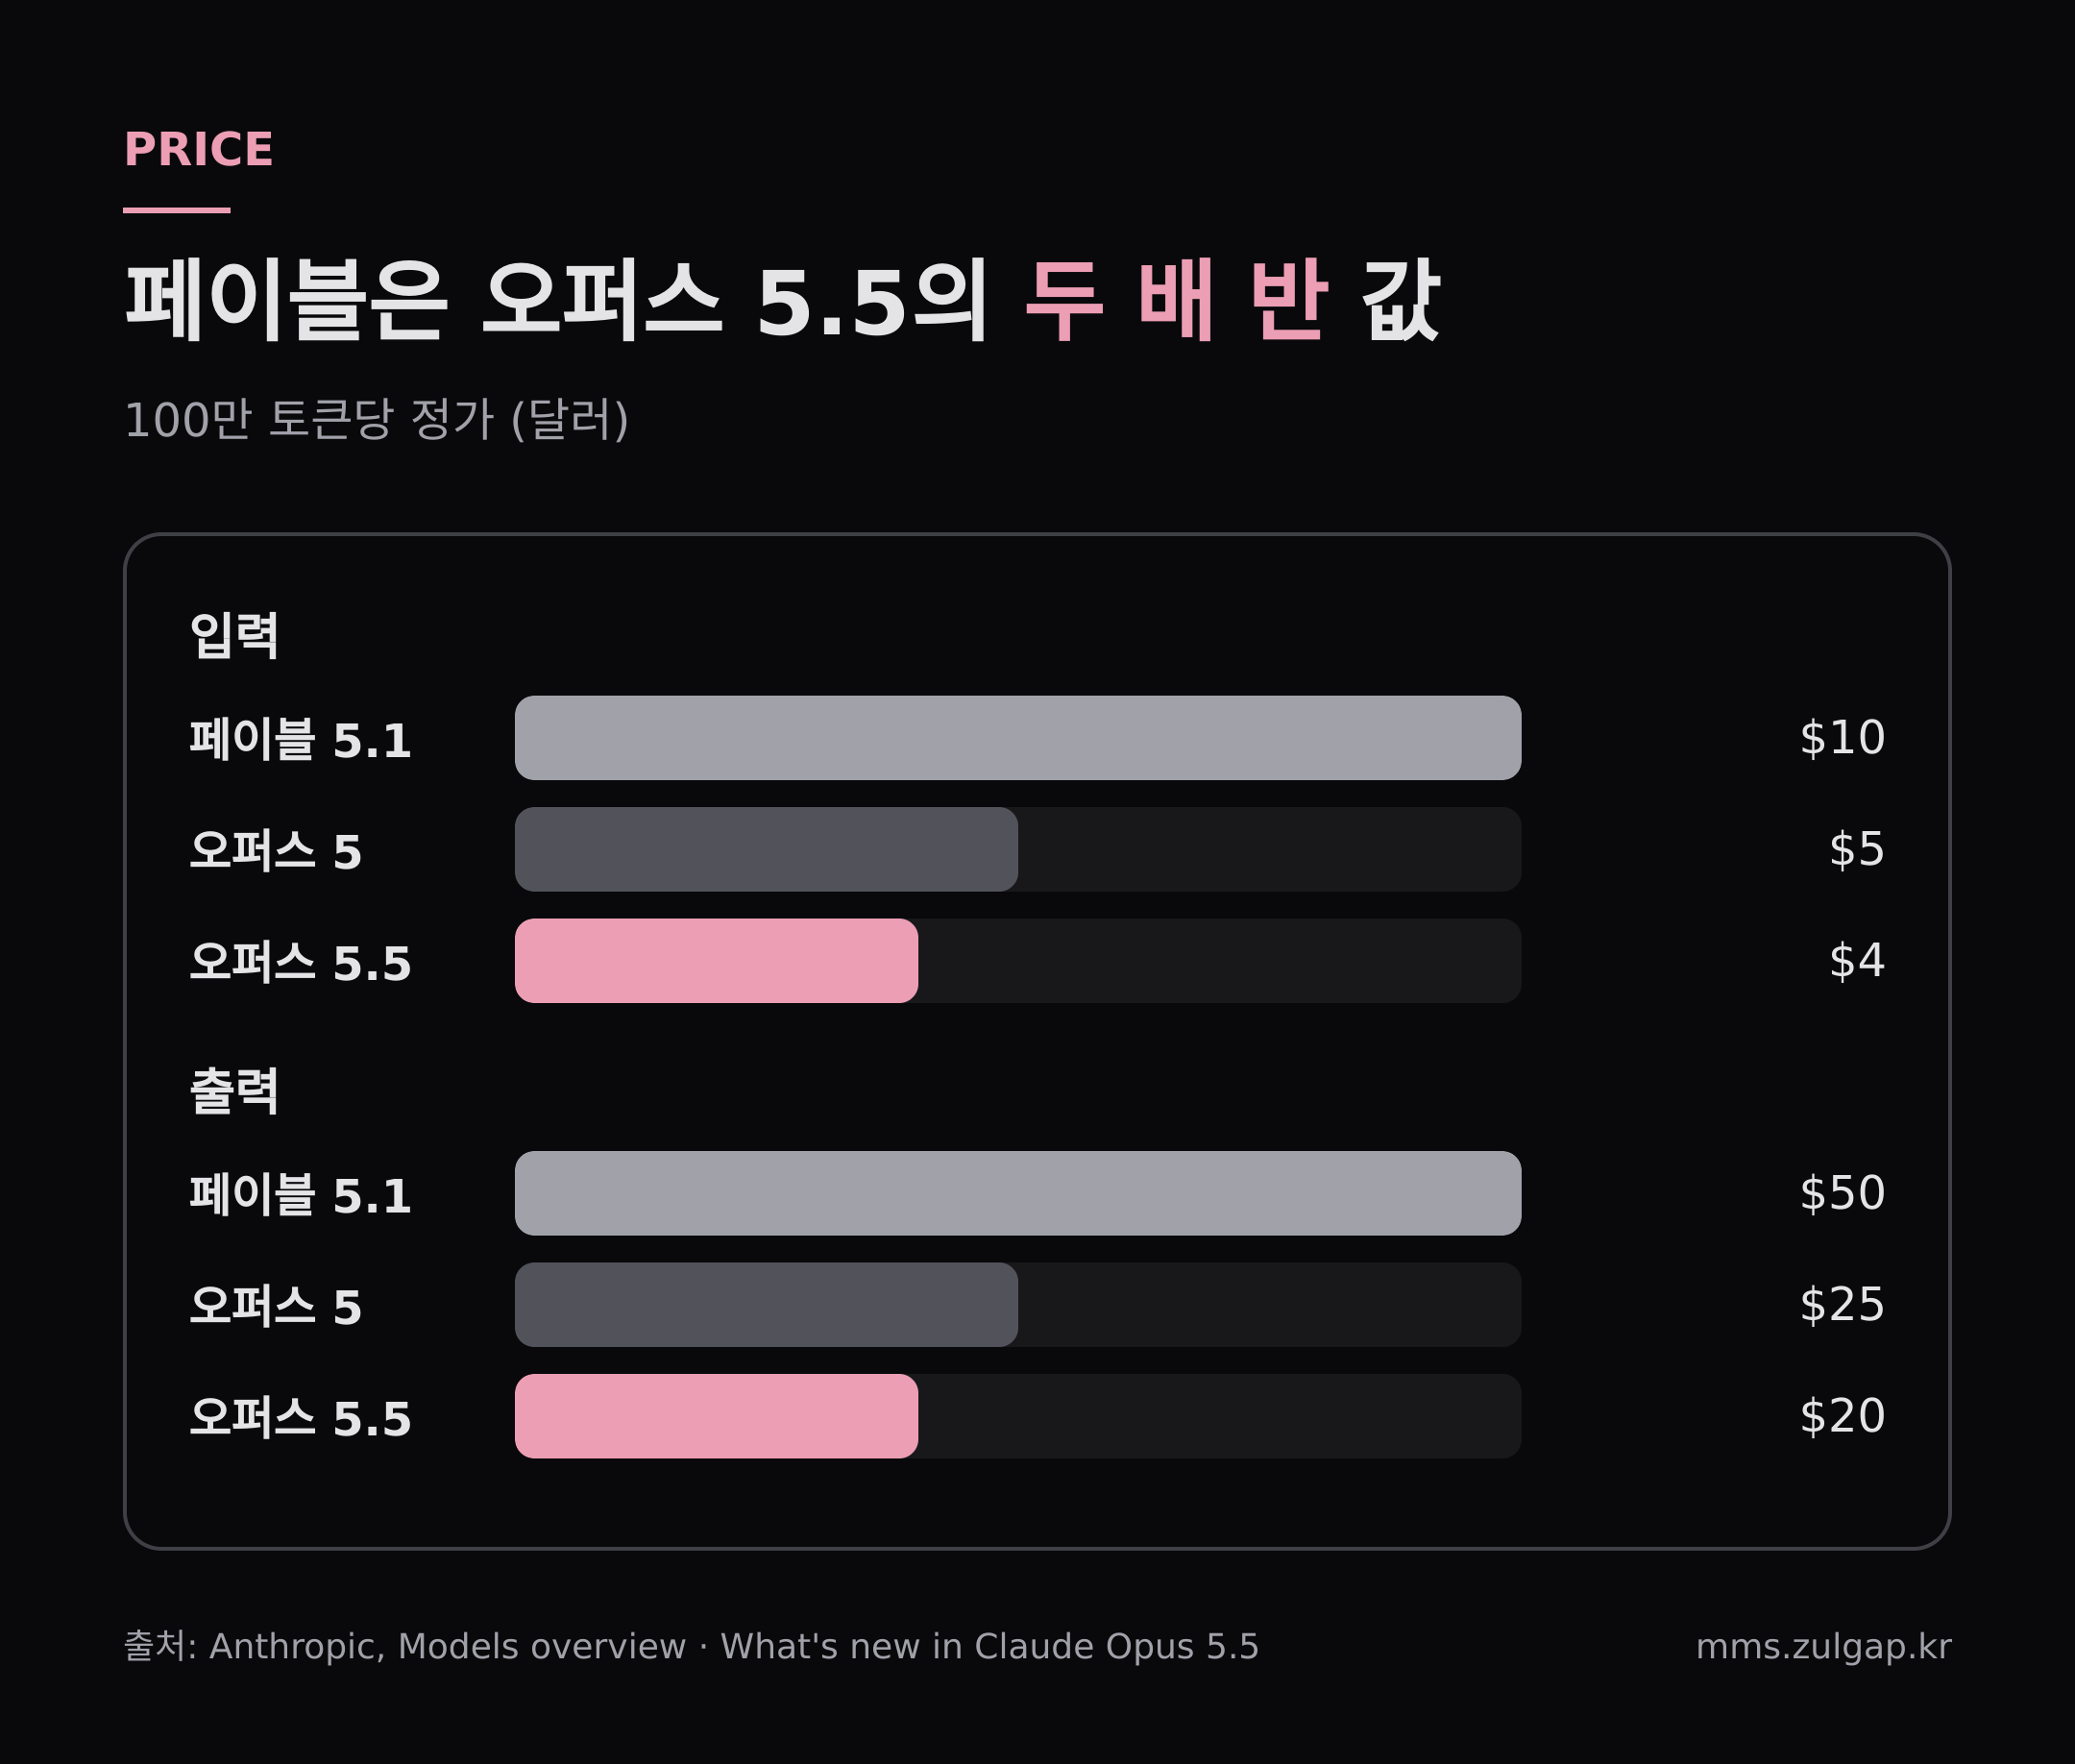
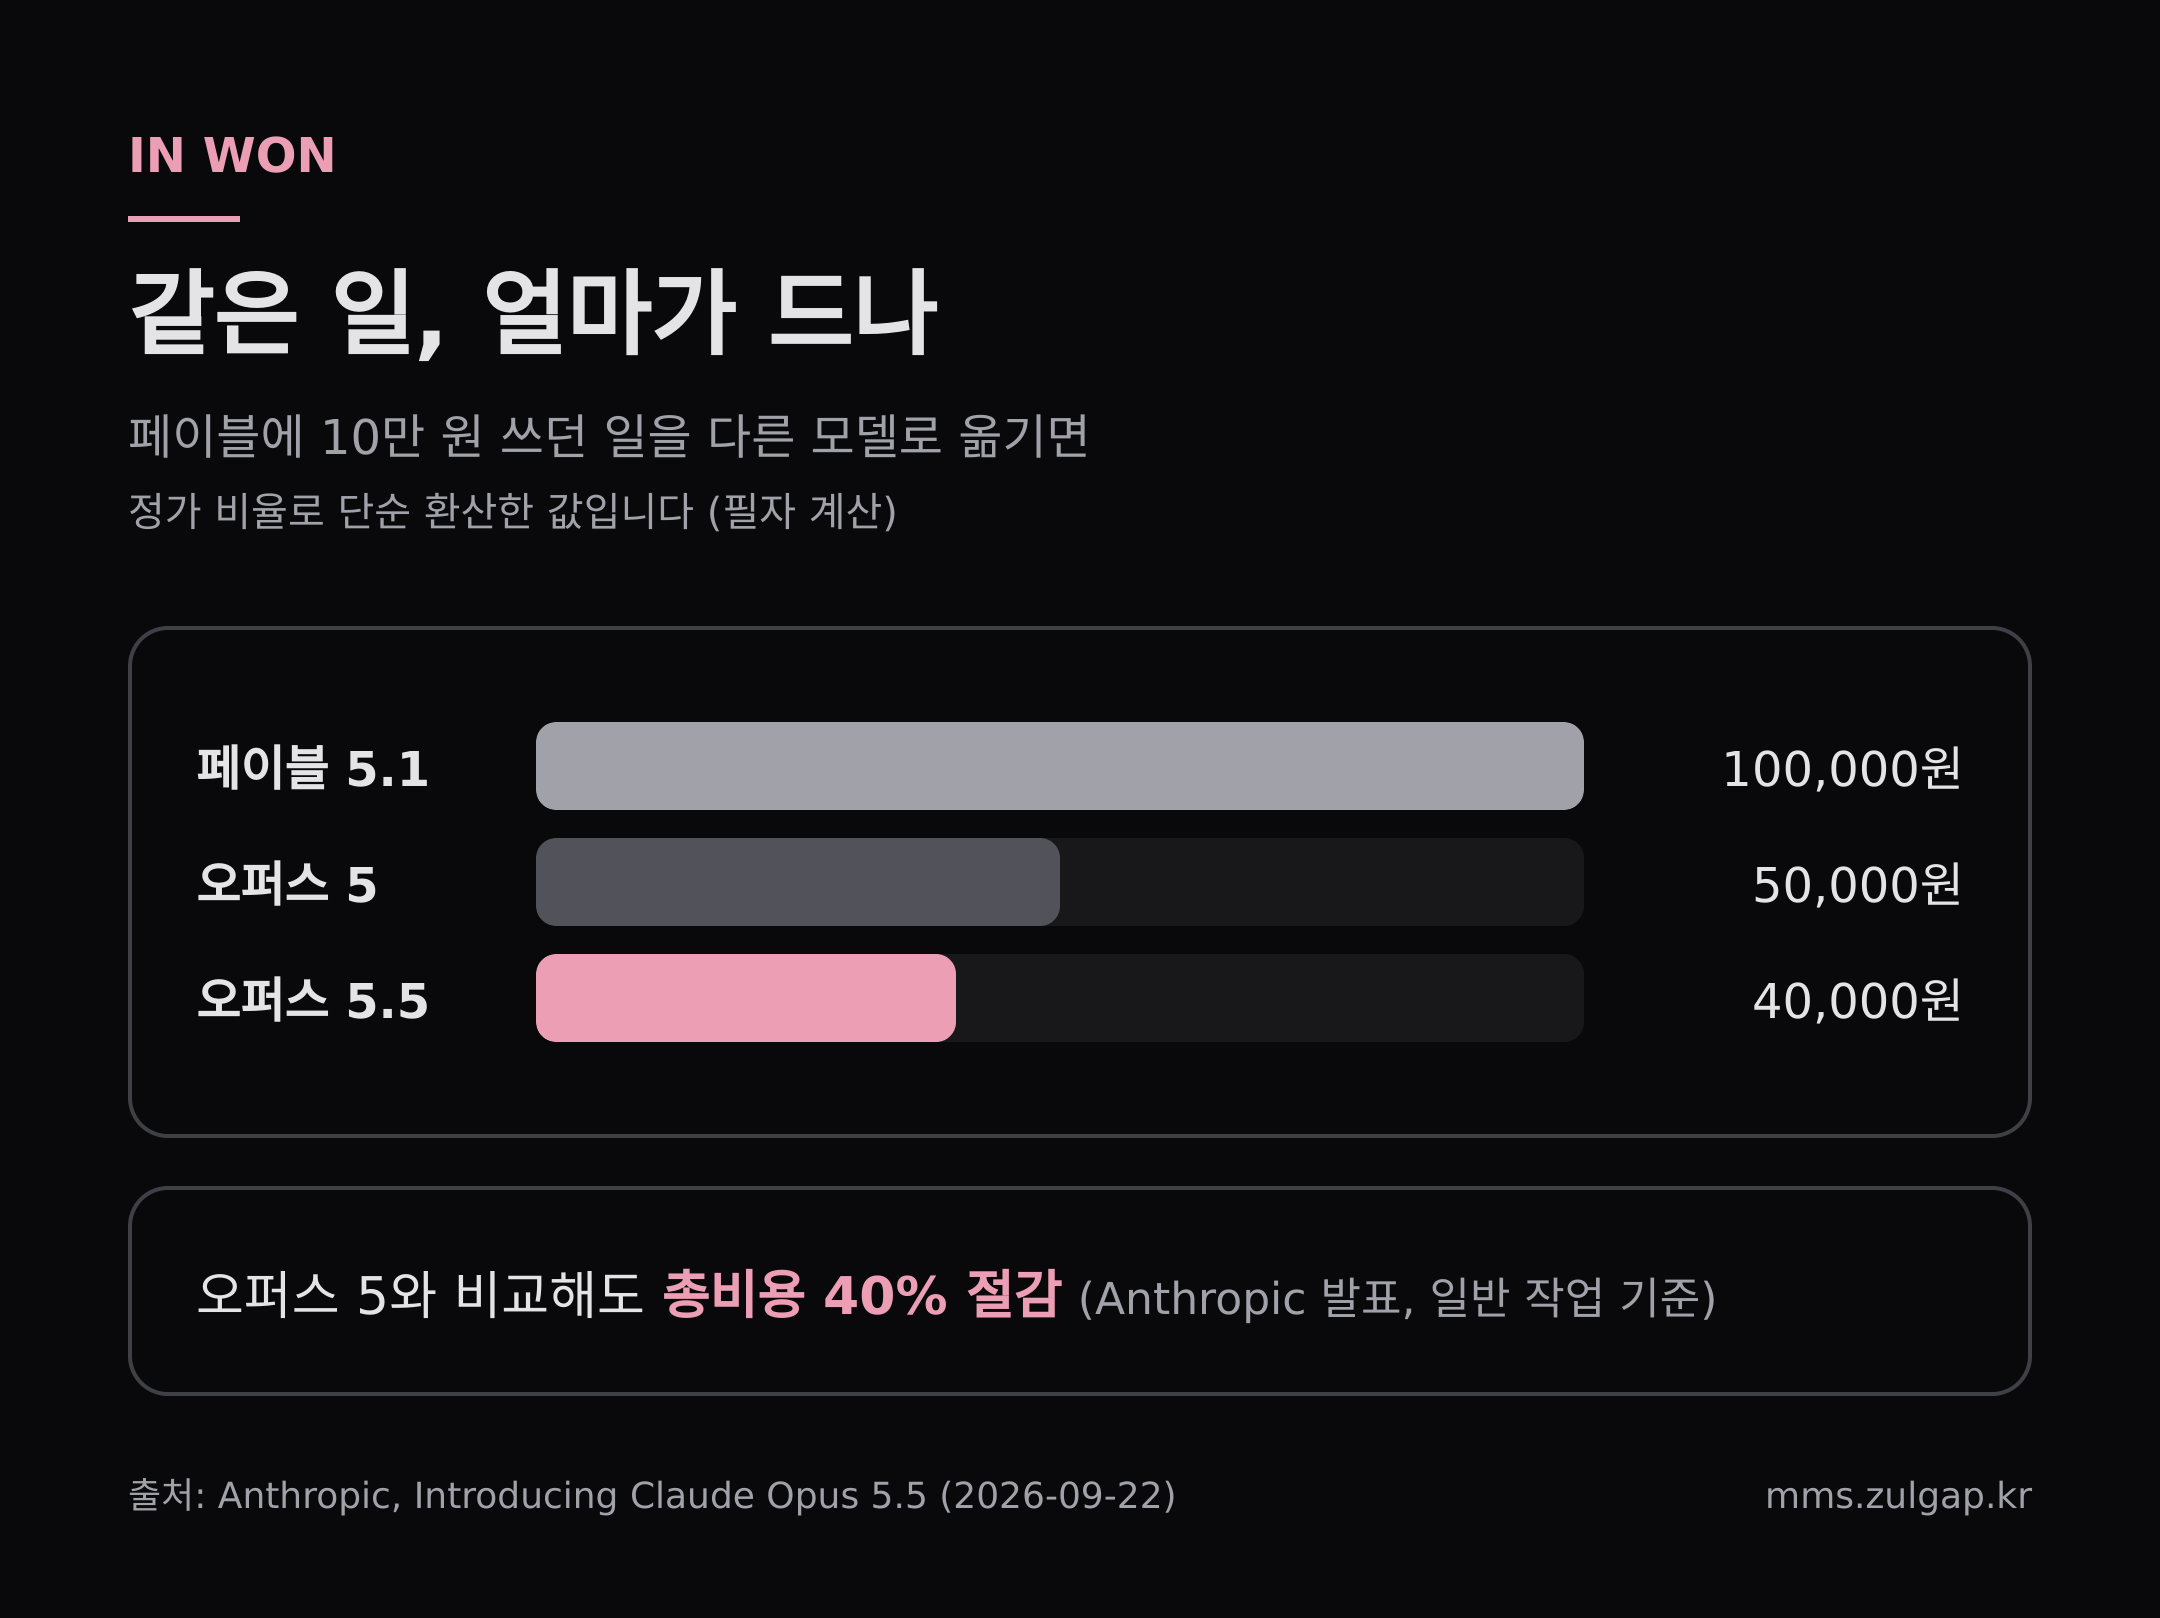
💬 쉽게 말하면 · 같은 일을 맡기면 페이블은 오퍼스 5.5의 두 배 반 값이 나옵니다. 페이블에 10만 원을 쓰던 일이면 오퍼스 5.5로는 4만 원입니다.
오퍼스 5와 비교해도 싸졌습니다. 단가가 20% 내려갔고, 같은 일을 하는 데 쓰는 양도 줄어서 일반적인 작업 기준 총비용이 40% 줄었다고 Anthropic은 밝혔습니다. 속도도 30% 이상 빨라졌습니다.
그렇다면 당연히 다음 질문이 나옵니다. 싸면 성능이 떨어지는 것 아닌가.
싸면 성능이 떨어지지 않나 — 시험 9개 비교
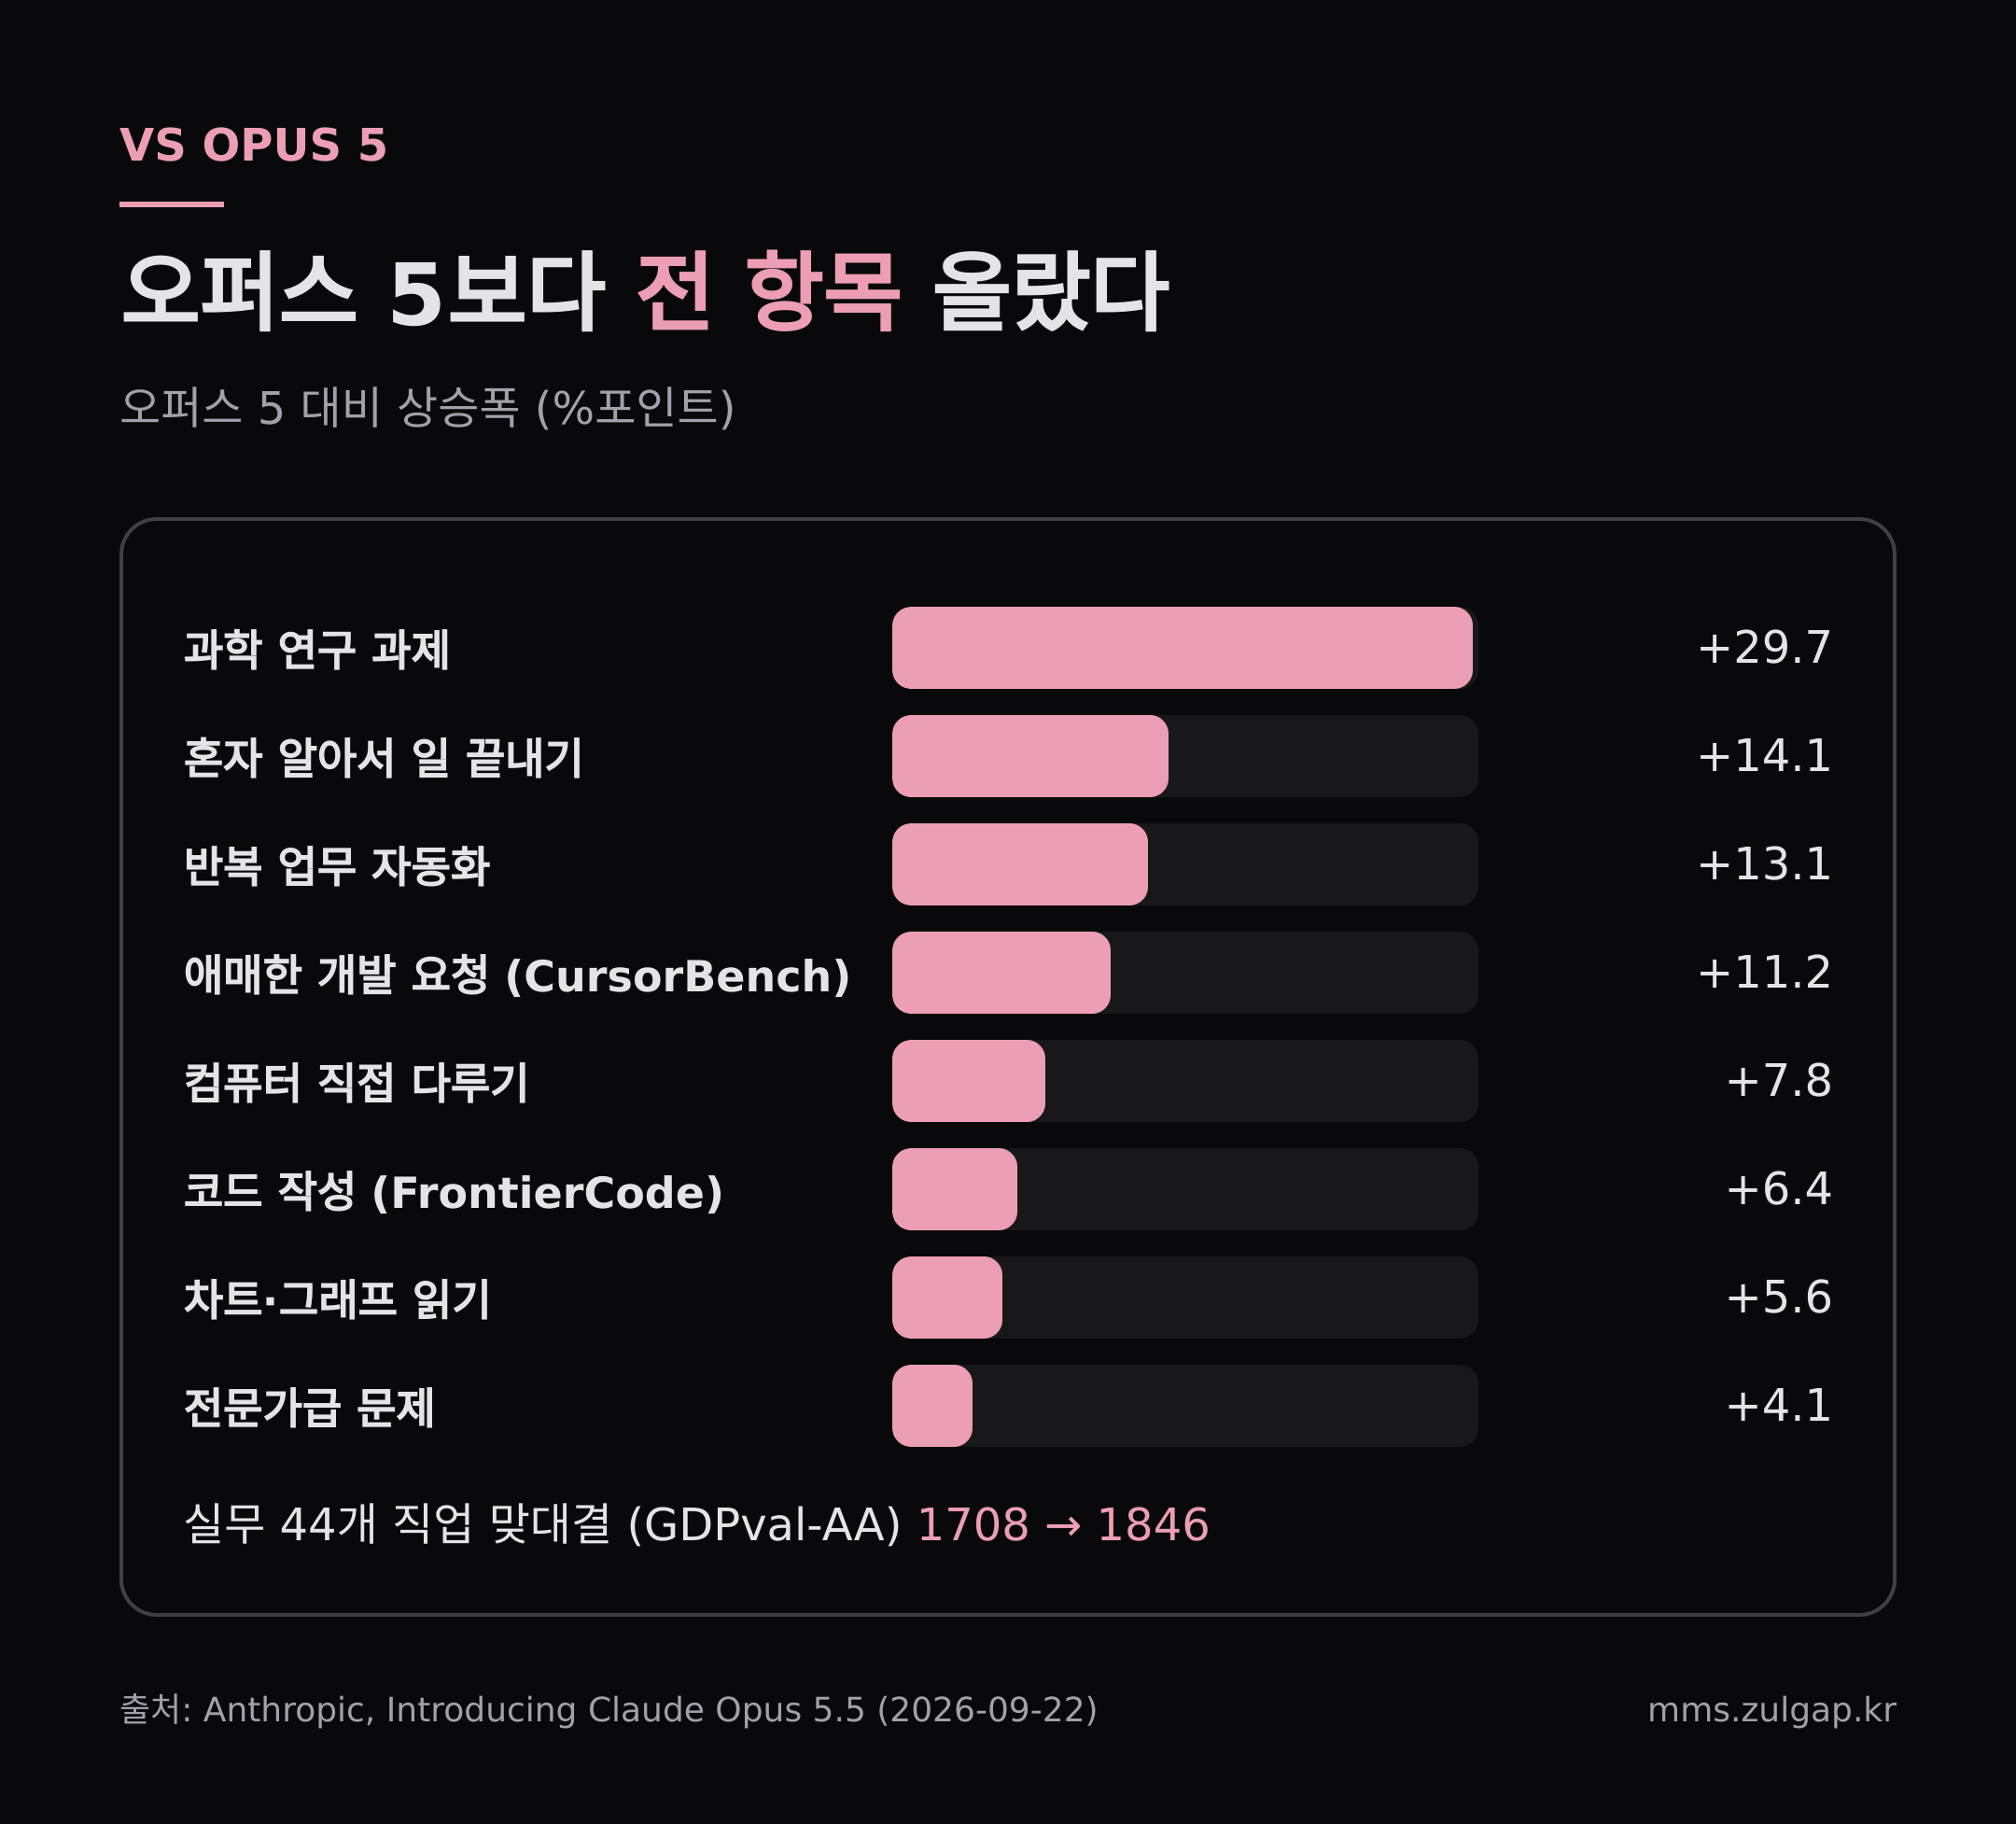
떨어지지 않았습니다. 오히려 발표문에 실린 시험 9개 전부에서 클로드 오퍼스 5.5가 페이블 5.1보다 높게 나왔습니다. Anthropic 발표문은 이렇게 적었습니다.
"performs at the level of Claude Fable 5.1 on most work" — Anthropic, Introducing Claude Opus 5.5
💬 쉽게 말하면 · 웬만한 일은 페이블만큼 해낸다는 뜻입니다.
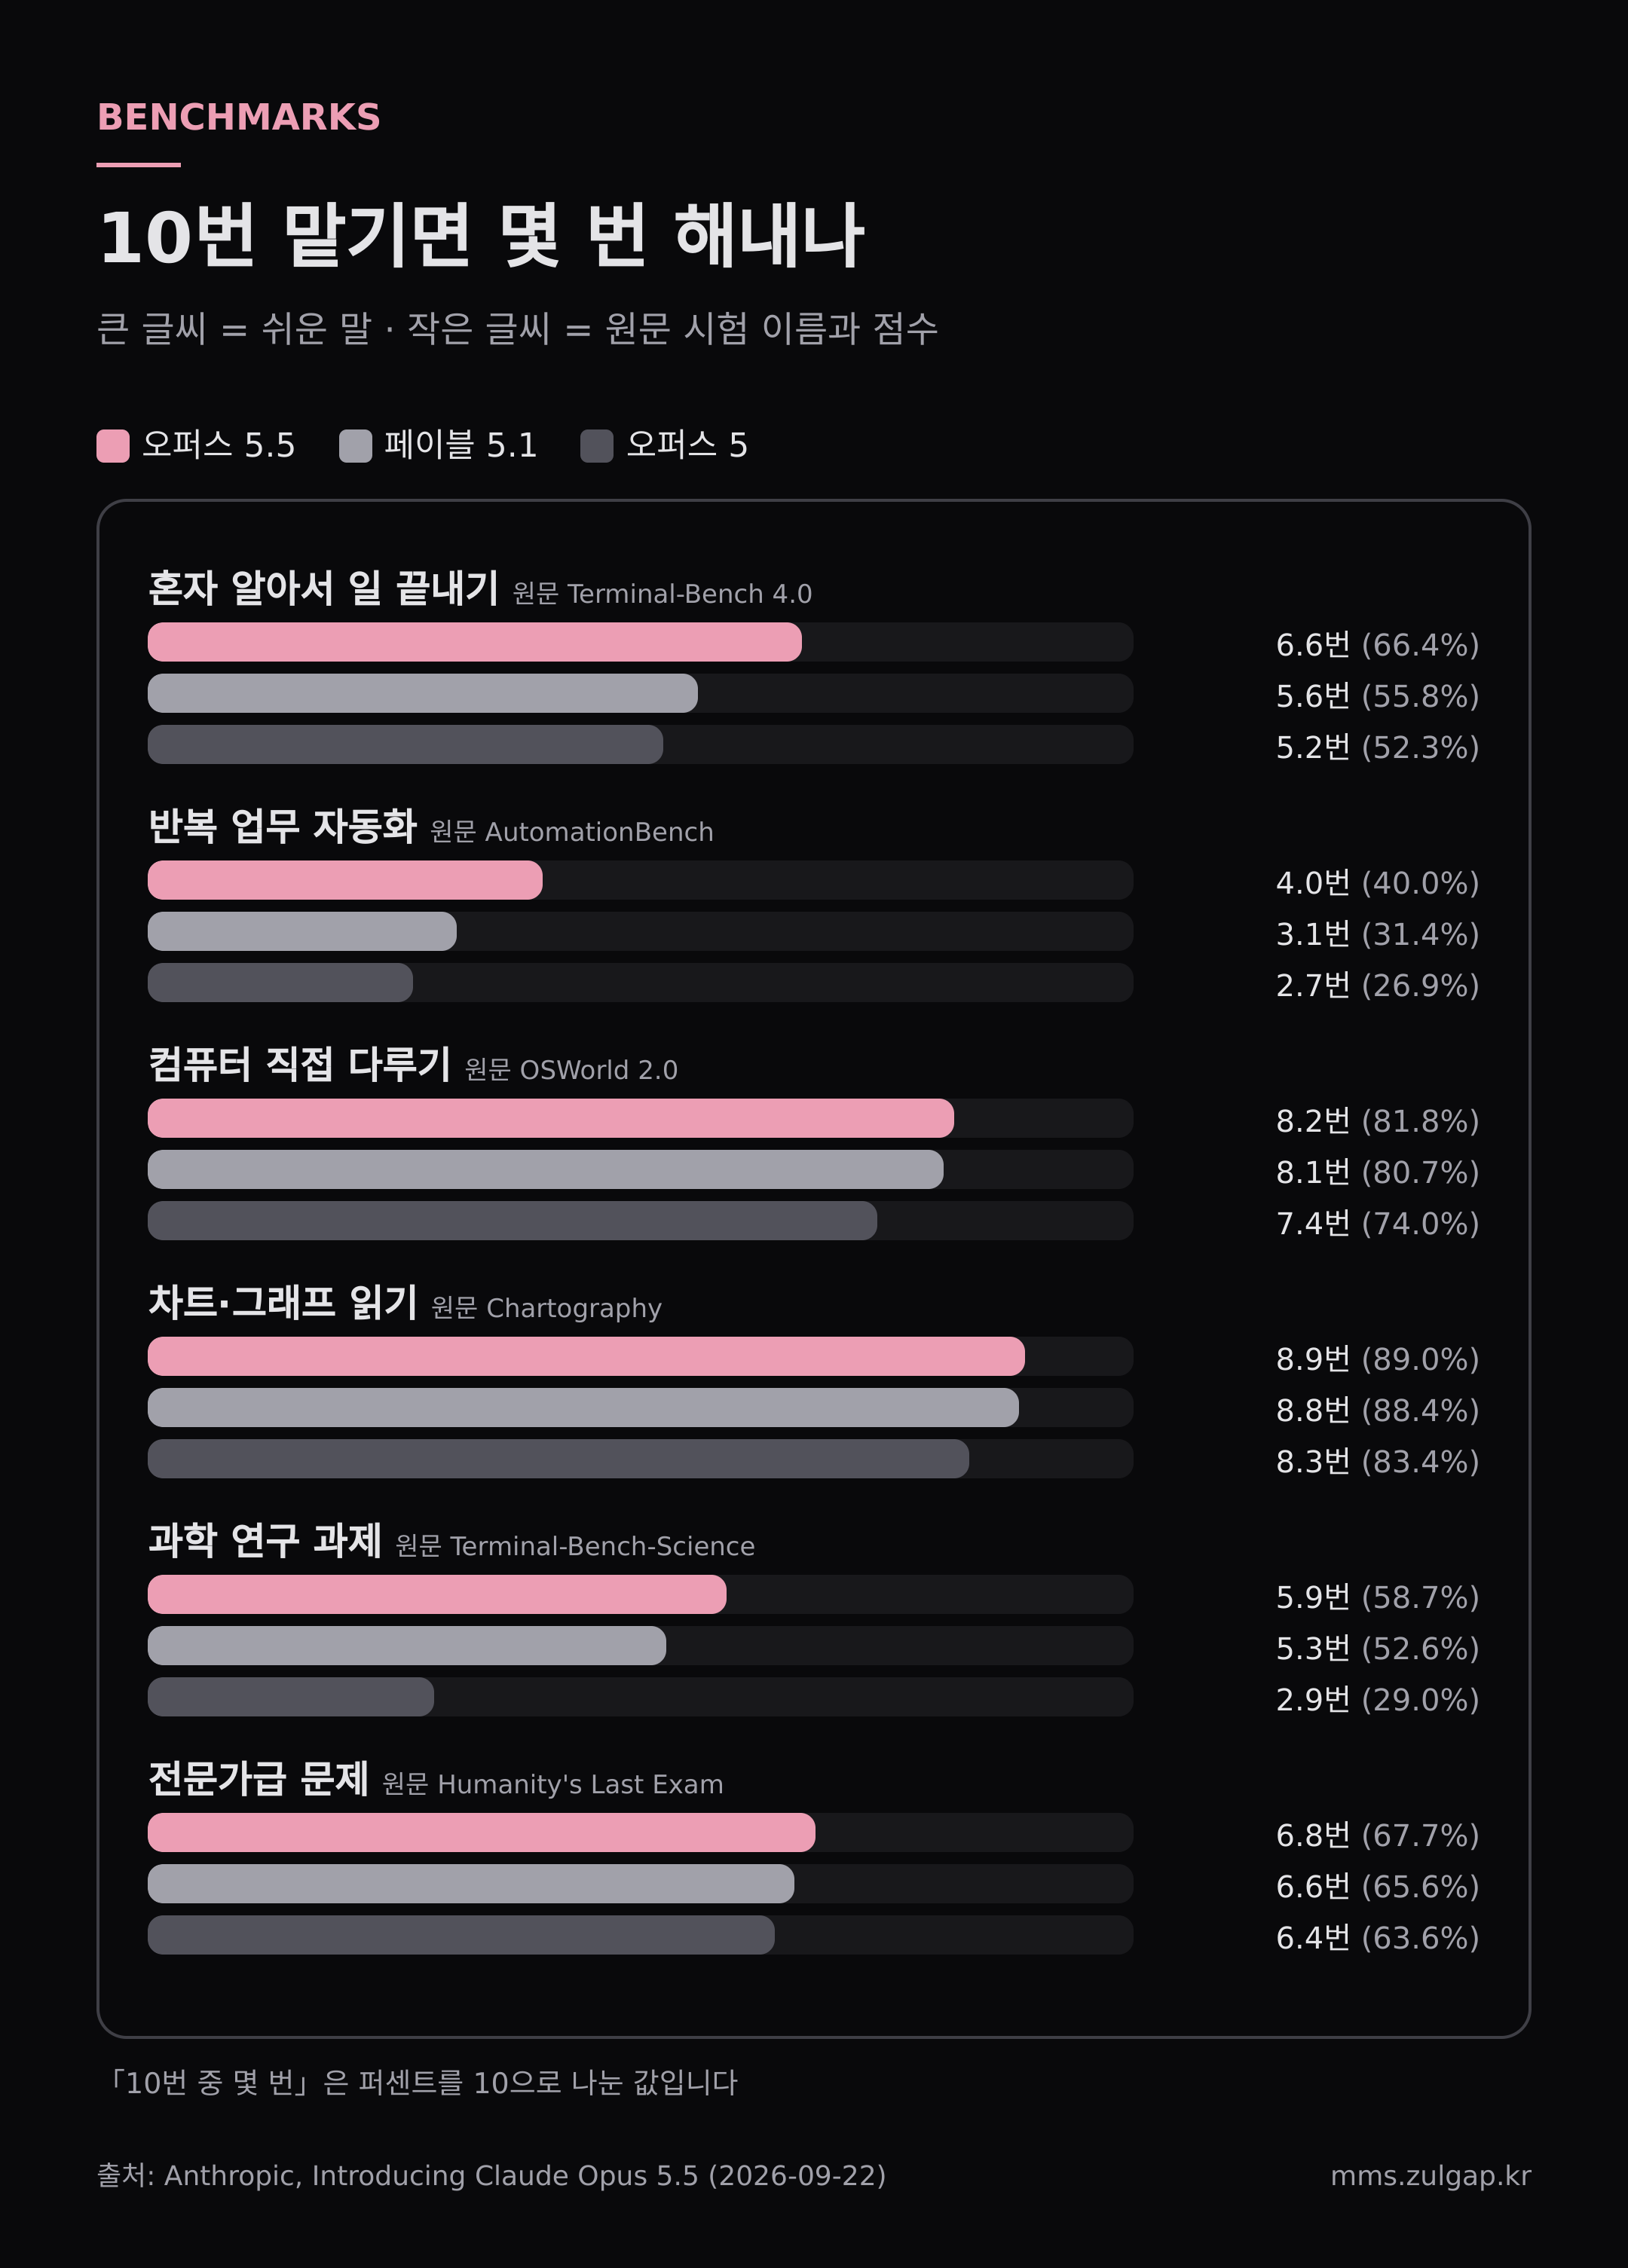
손님이 체감하는 말로 바꿔 보면 이렇습니다. (퍼센트를 「10번 맡기면 몇 번 해내나」로 바꾼 값입니다. 괄호 안이 원문 점수입니다.)
| 10번 맡기면 몇 번 해내나 | 오퍼스 5.5 | 페이블 5.1 | 오퍼스 5 | 📄 원문 시험 이름 |
|---|---|---|---|---|
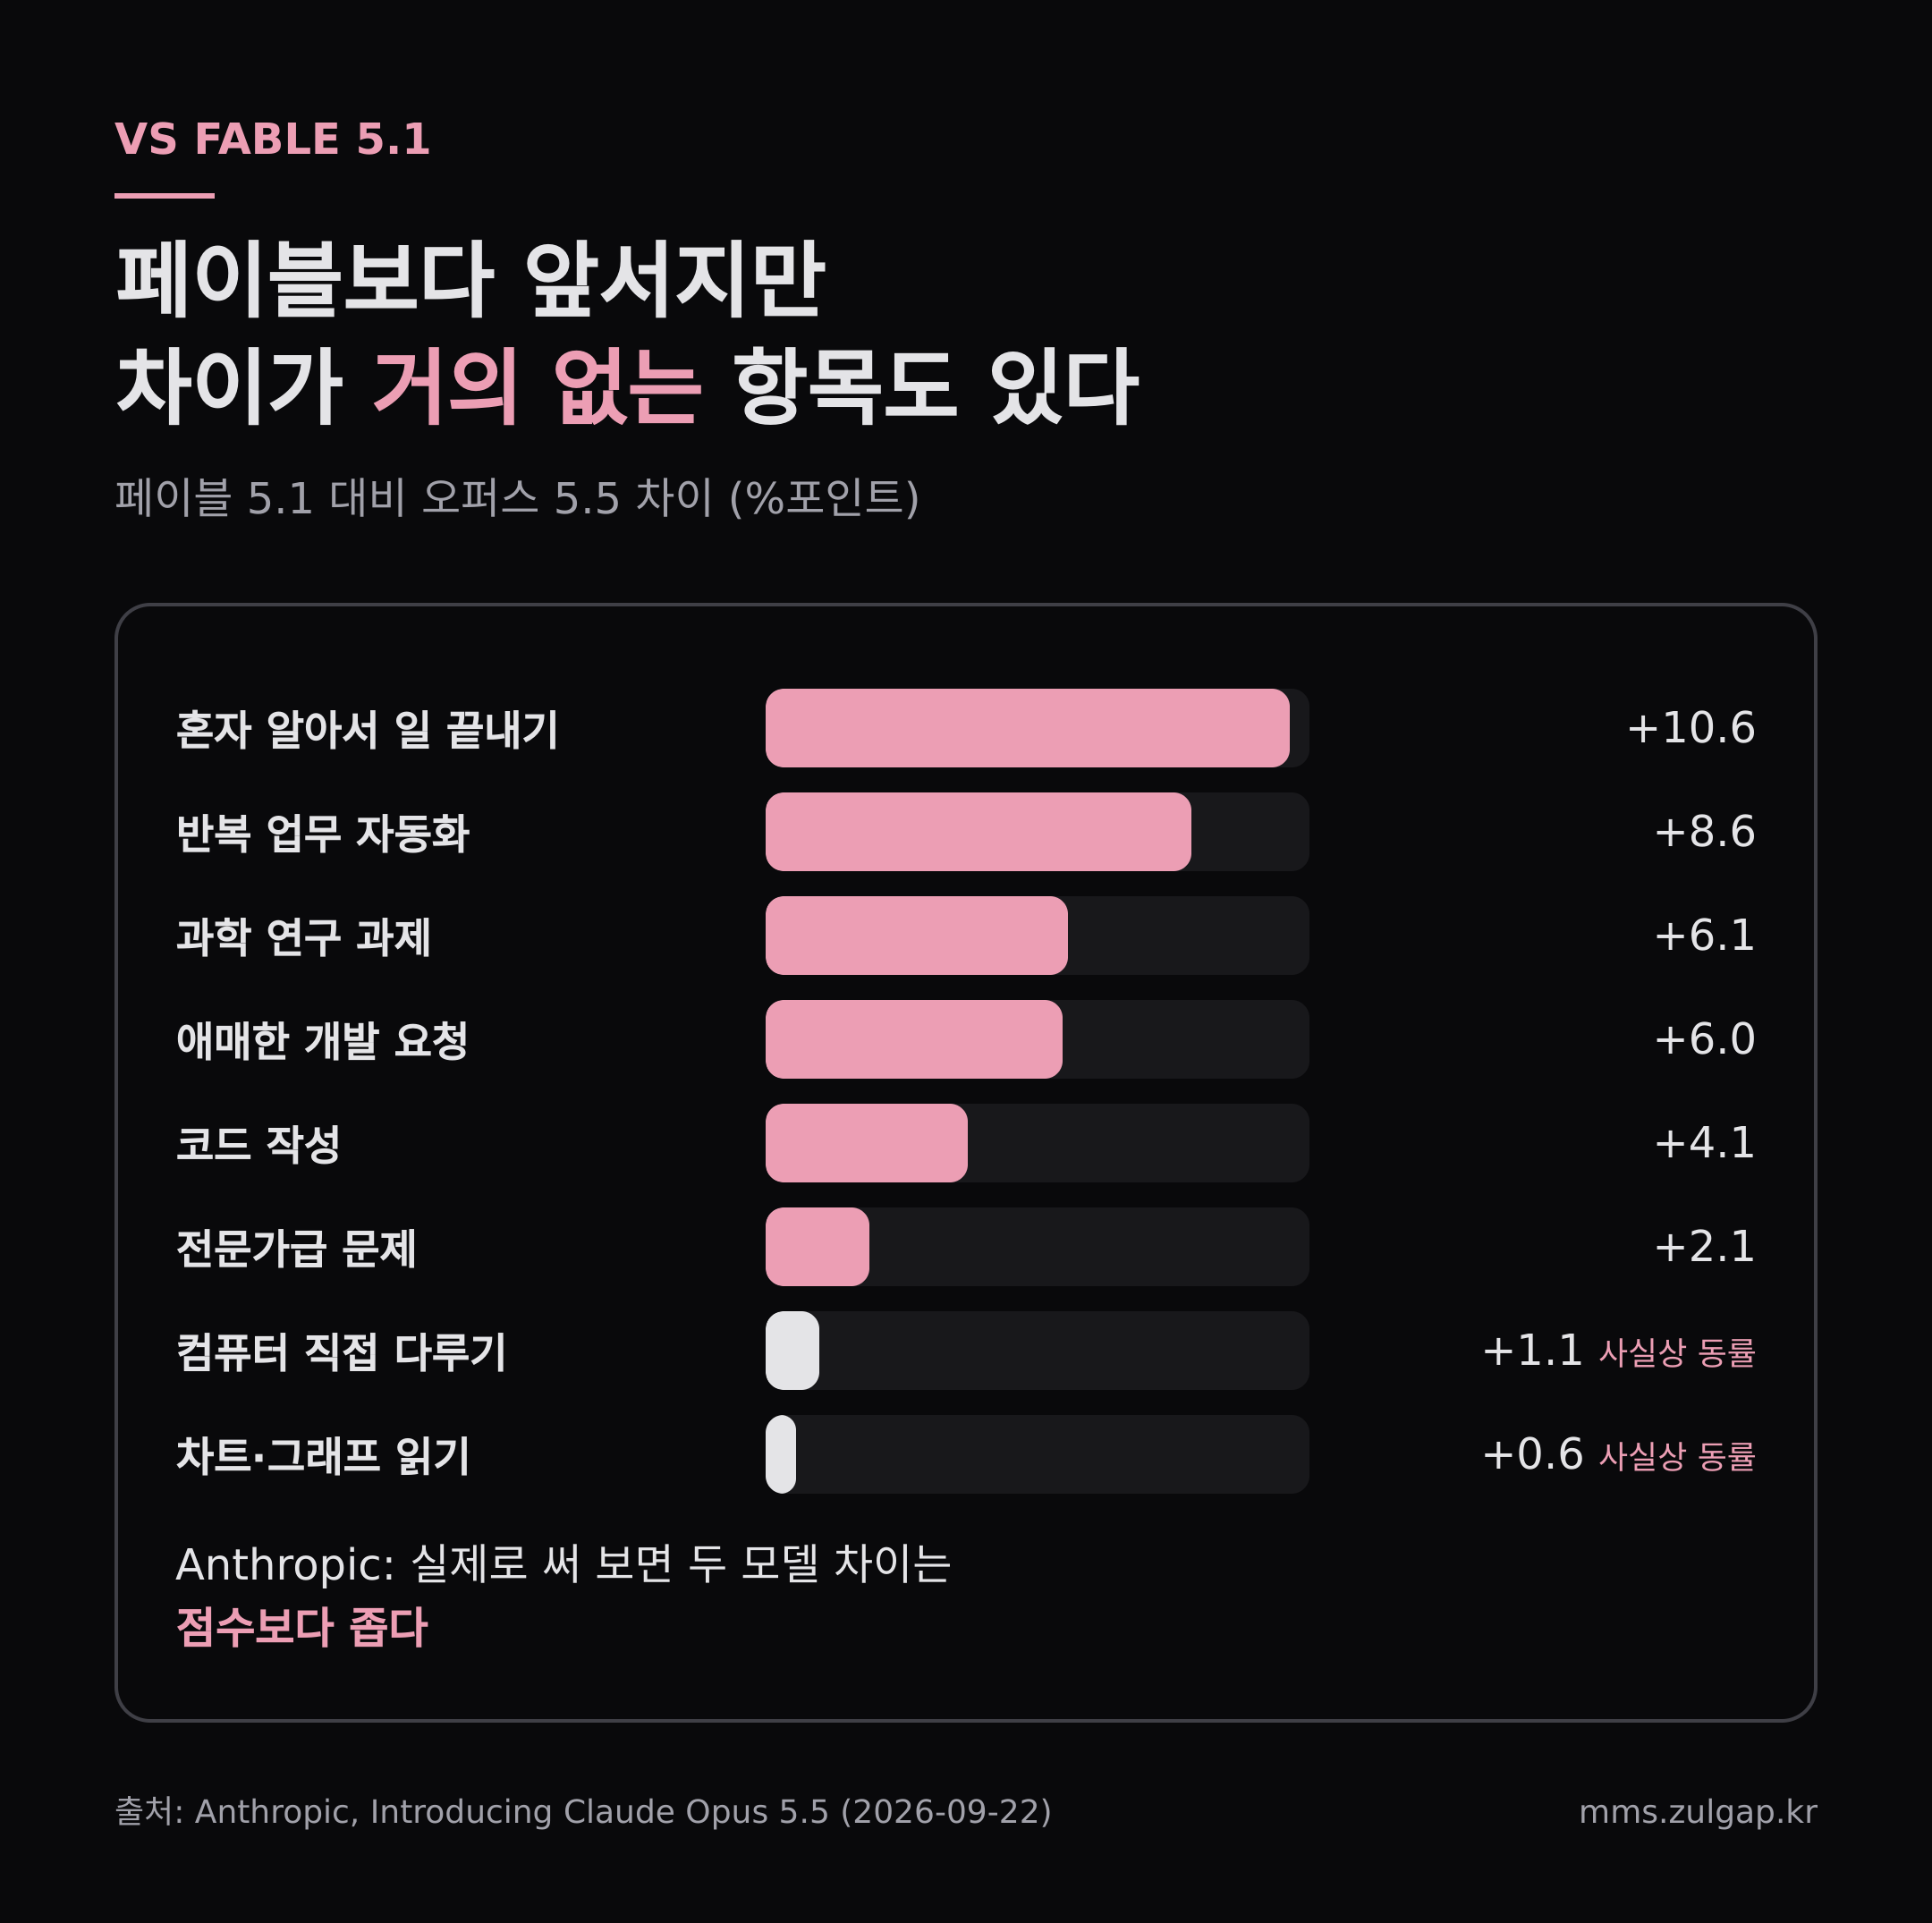
| 여러 단계를 혼자 알아서 끝내기 | 6.6번 (66.4%) | 5.6번 (55.8%) | 5.2번 (52.3%) | Terminal-Bench 4.0 |
| 반복 업무 자동화 | 4.0번 (40.0%) | 3.1번 (31.4%) | 2.7번 (26.9%) | AutomationBench |
| 마우스·키보드로 컴퓨터 직접 다루기 | 8.2번 (81.8%) | 8.1번 (80.7%) | 7.4번 (74.0%) | OSWorld 2.0 |
| 차트·그래프 읽기 | 8.9번 (89.0%) | 8.8번 (88.4%) | 8.3번 (83.4%) | Chartography |
| 과학 연구 과제 혼자 풀기 | 5.9번 (58.7%) | 5.3번 (52.6%) | 2.9번 (29.0%) | Terminal-Bench-Science |
| 전문가급 어려운 문제 | 6.8번 (67.7%) | 6.6번 (65.6%) | 6.4번 (63.6%) | Humanity's Last Exam |
보고서, 분석 같은 44개 직업의 실제 업무를 맞대결시키는 시험(GDPval-AA)도 있습니다. 오퍼스 5.5가 1846점, 페이블 5.1이 1735점, 오퍼스 5가 1708점입니다. 이 점수는 체스 등급처럼 맞대결 승률을 나타내는 방식이라, 점수 차를 승률로 환산하면 오퍼스 5.5 결과물이 오퍼스 5보다 나은 경우가 10번 중 7번쯤 됩니다(환산은 필자 계산).
다만 공정하게 짚어 둘 것이 있습니다. 컴퓨터 조작과 차트 읽기는 페이블과 차이가 1%포인트 안팎이라 사실상 비슷합니다. 그리고 Anthropic 스스로도 실제로 써 보면 두 모델의 차이가 점수보다 좁다고 밝혔습니다. 점수표만 보고 페이블을 한참 아래로 볼 일은 아니라는 뜻입니다.
그러면 시험 말고 실제 일에서는 어땠을까요.
실제 일로 맞붙이면 — 시간과 비용
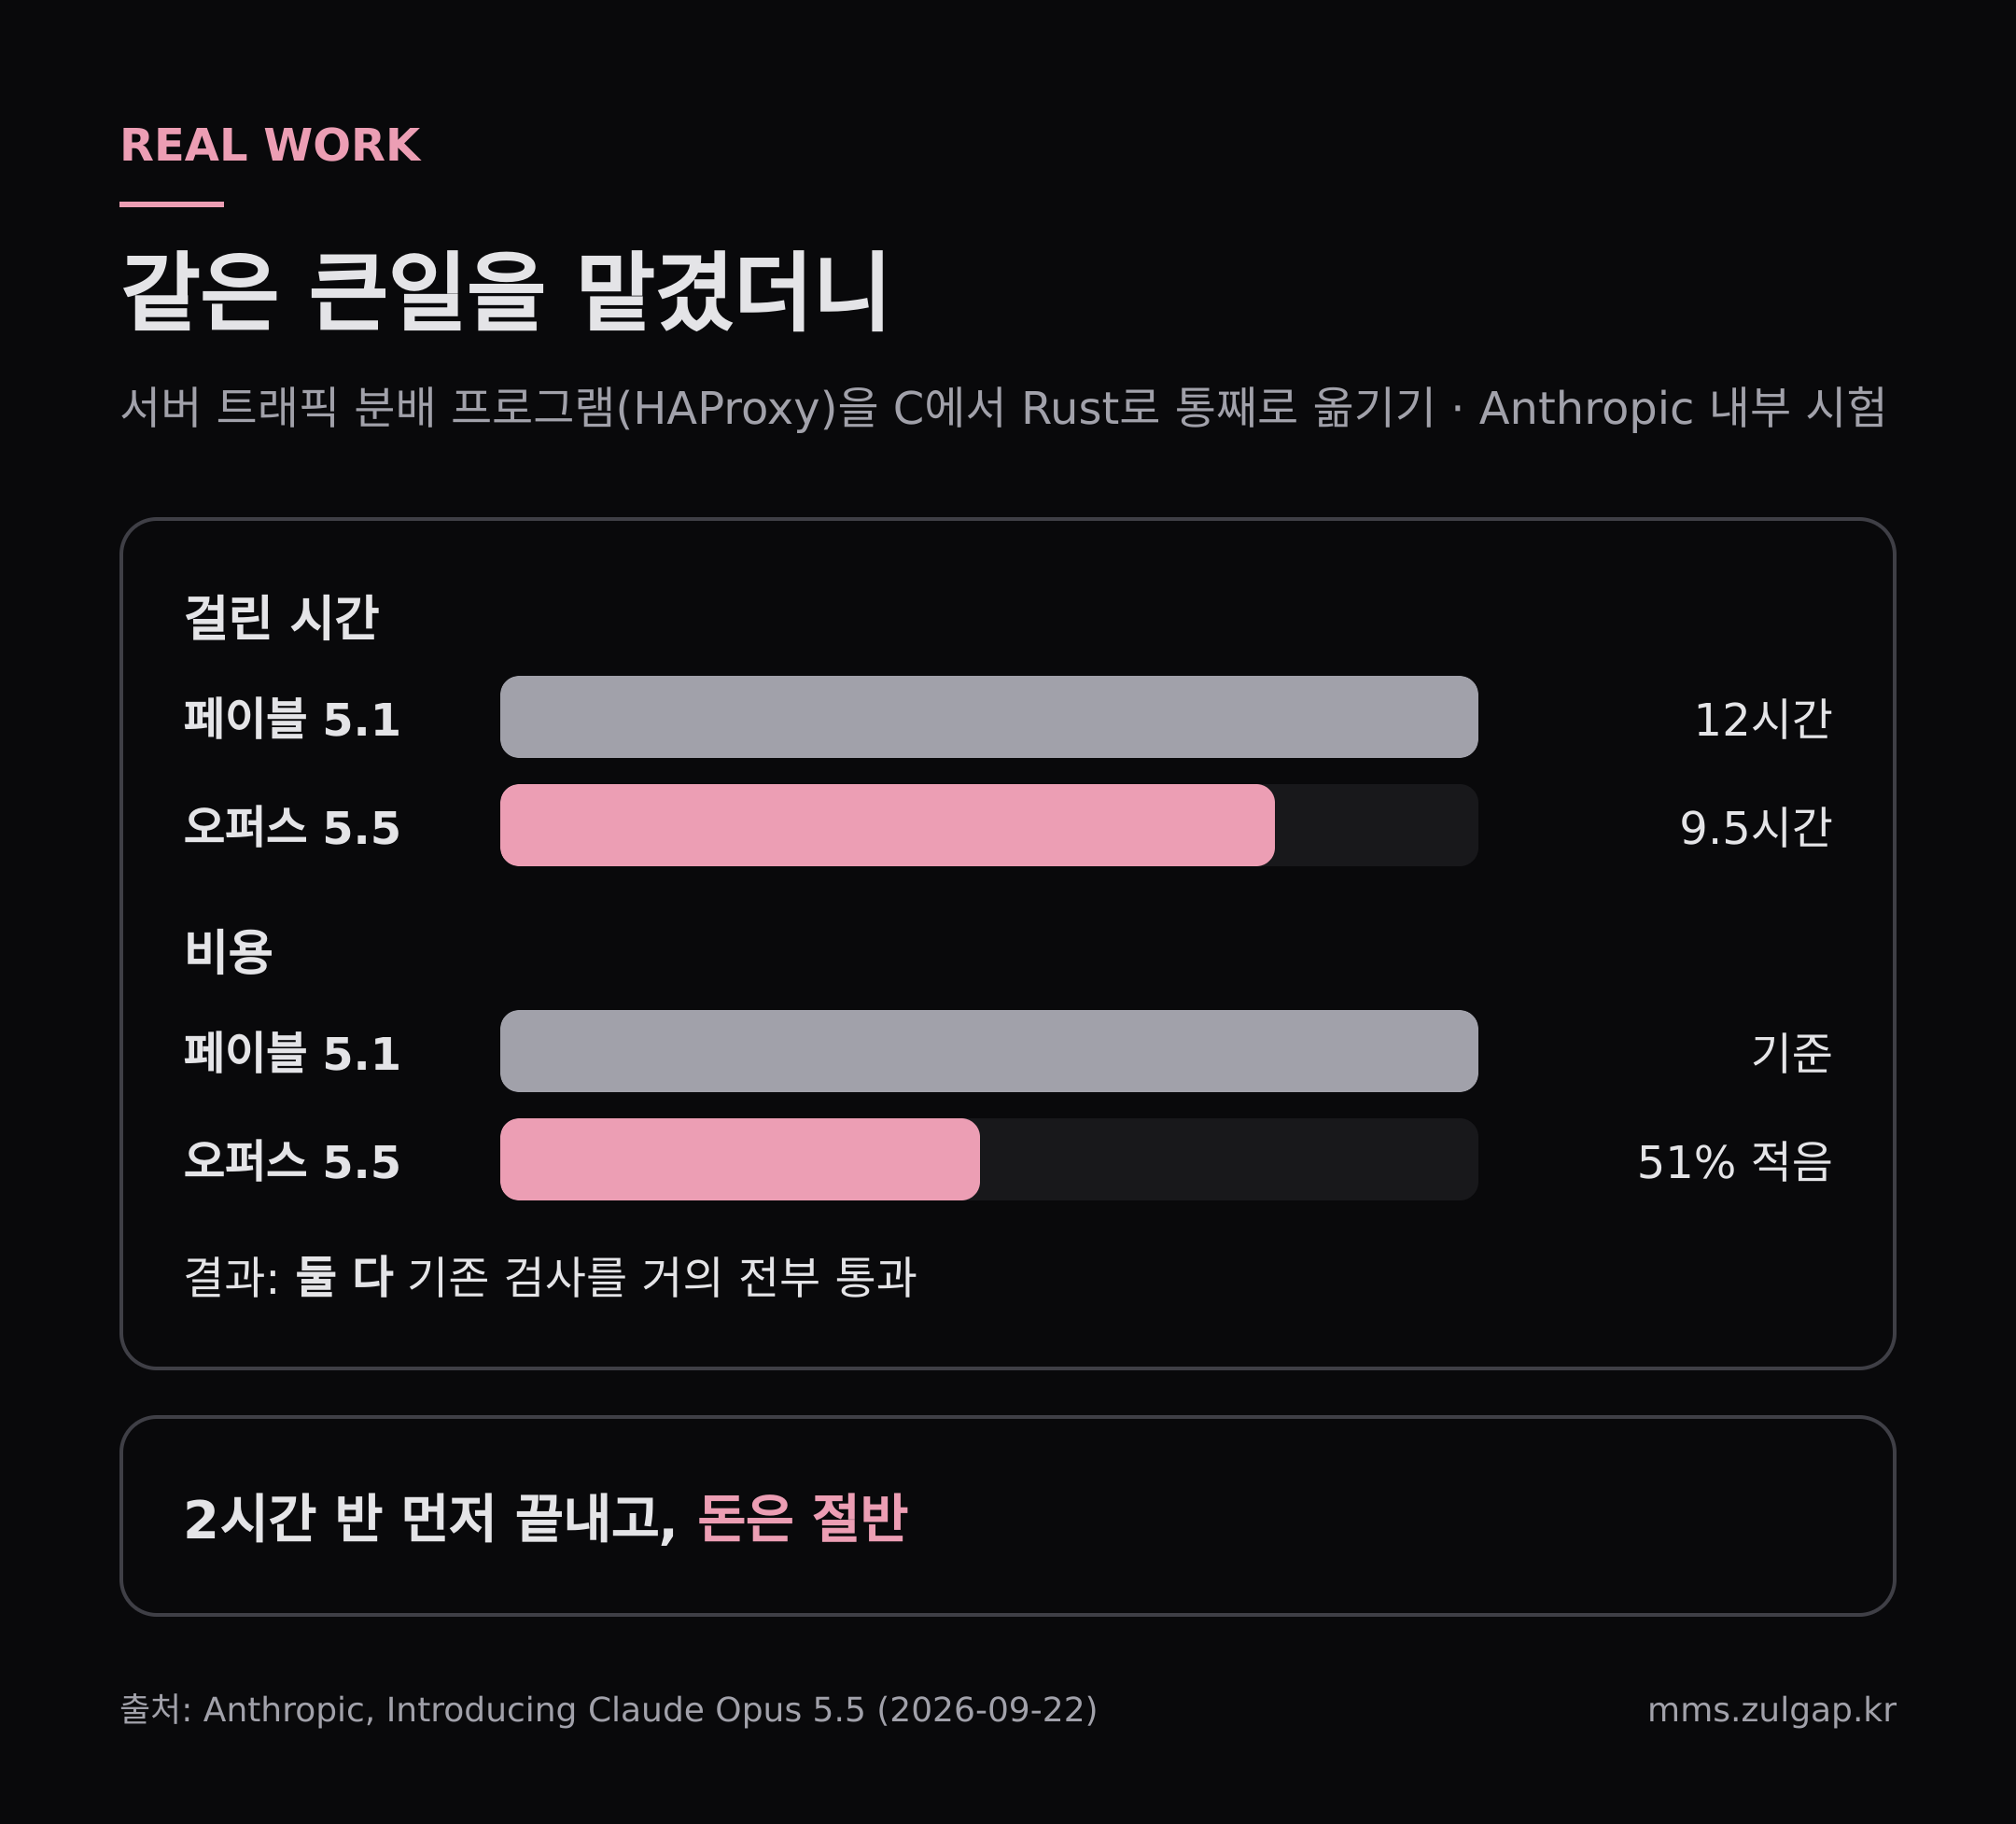
Anthropic이 내부에서 두 모델에게 같은 큰일을 맡긴 기록이 있습니다. 서버 트래픽을 나눠 주는 프로그램(HAProxy)을 다른 프로그래밍 언어로 통째로 옮기는 작업입니다.
| 오퍼스 5.5 | 페이블 5.1 | |
|---|---|---|
| 걸린 시간 | 9.5시간 | 12시간 |
| 비용 | 51% 적음 | 기준 |
| 결과 | 둘 다 기존 검사를 거의 전부 통과 | 같음 |
💬 쉽게 말하면 · 같은 큰일을 맡겼더니 2시간 반 먼저 끝내고 돈은 절반만 들었습니다. 결과물 품질은 같았습니다.
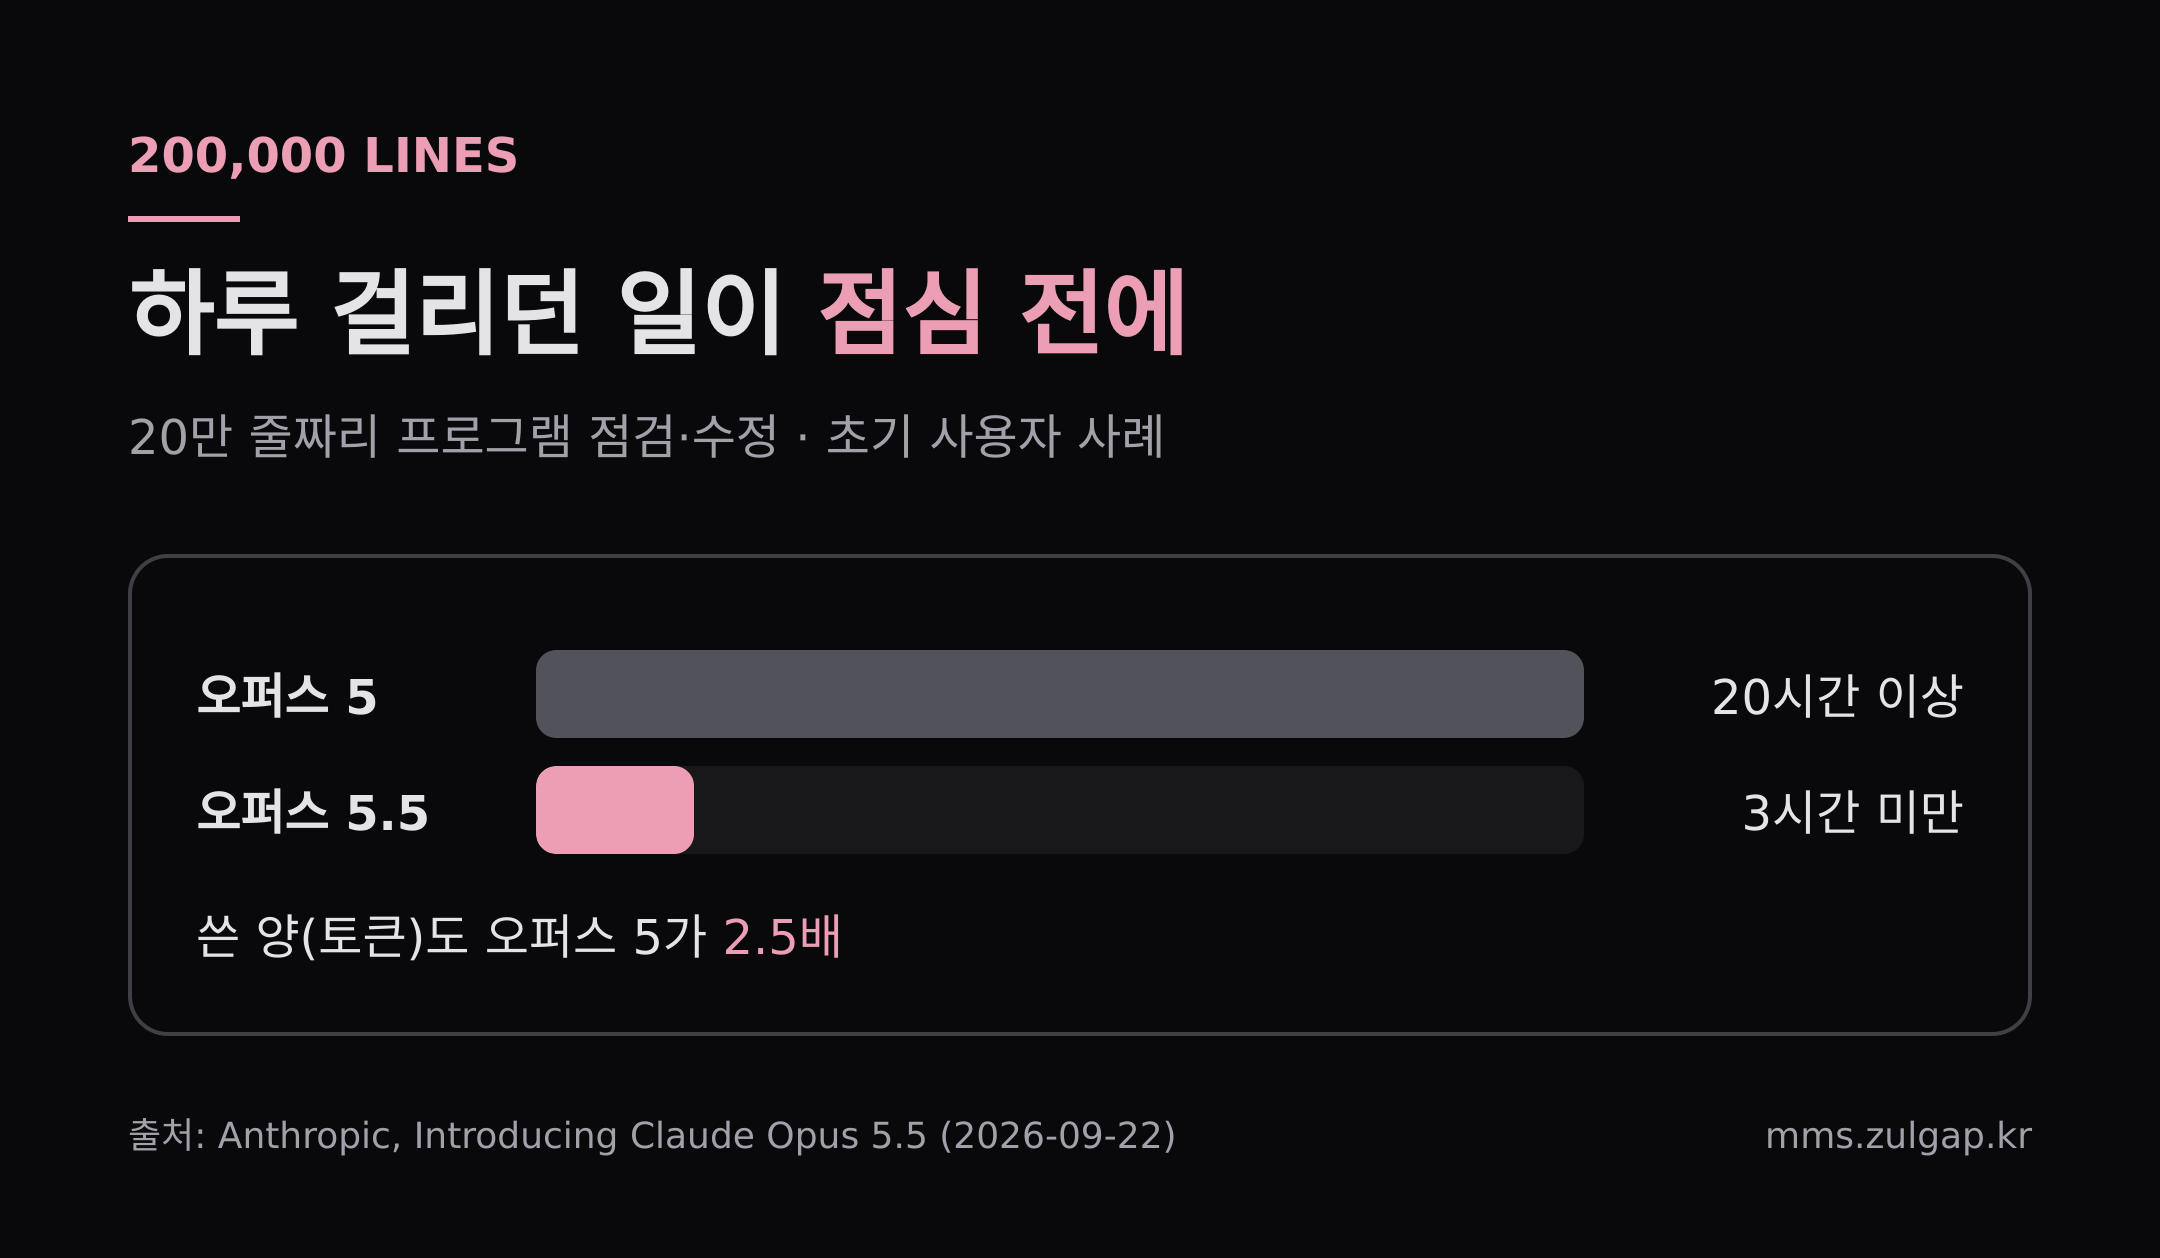
오퍼스 5와의 차이는 더 큽니다. 한 초기 사용자가 20만 줄짜리 프로그램을 점검하고 고치게 했더니, 오퍼스 5는 20시간 넘게 걸렸고 오퍼스 5.5는 3시간이 안 걸렸습니다. 쓴 양도 오퍼스 5가 2.5배 많았습니다. 하루 걸리던 일이 점심 전에 끝난 셈입니다.
그렇다면 지금 오퍼스 5를 쓰고 있는 분은 무엇이 달라질까요.
오퍼스 5 쓰던 분은 뭐가 좋아지나
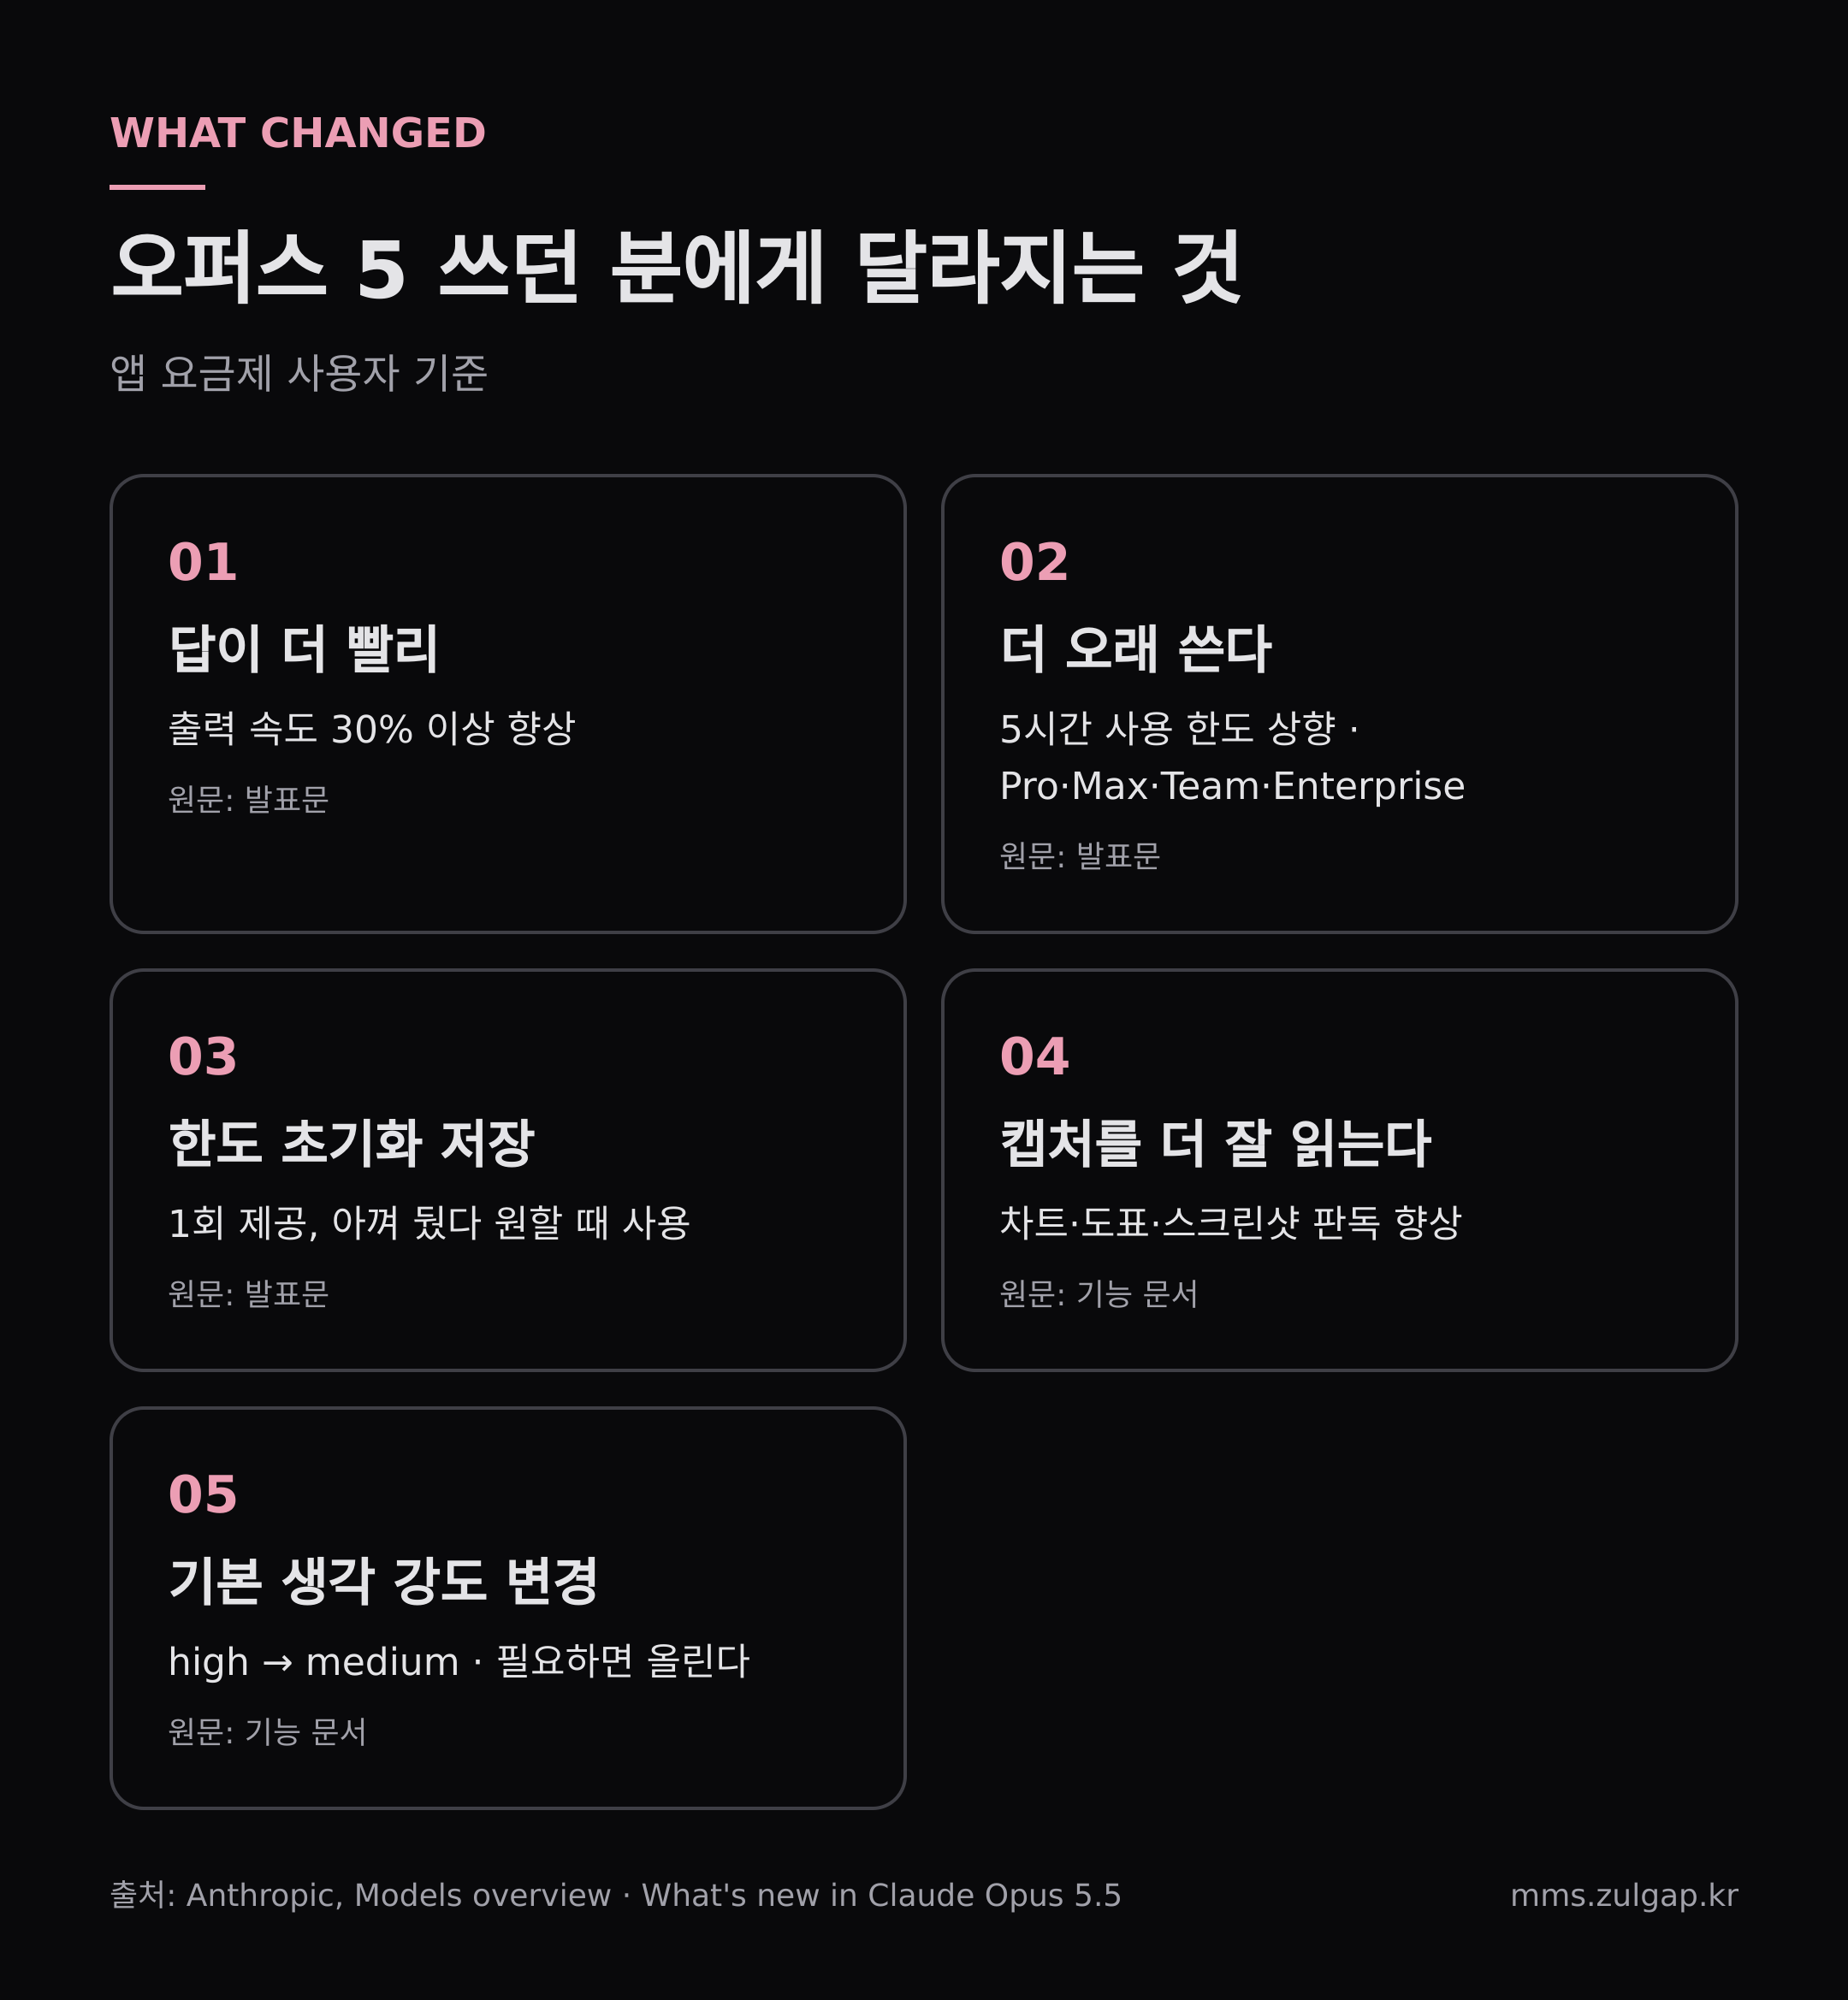
클로드 앱을 요금제로 쓰시는 분이 체감할 변화는 네 가지입니다.
| 달라진 점 | 📄 원문 근거 (요지) | 💬 쉽게 말하면 |
|---|---|---|
| 답이 더 빨리 나온다 | 발표문: 출력 속도 30% 이상 향상 | 기다리는 시간이 3분의 1가량 줄어듭니다 |
| 더 오래 쓸 수 있다 | 발표문: 5시간 사용 한도 상향 (Pro·Max·Team·Enterprise) | 같은 요금제로 한도에 덜 걸립니다 |
| 한도 초기화를 아껴 둘 수 있다 | 발표문: 한도 초기화 1회 제공, 저장 후 원할 때 사용 | 급한 날 꺼내 쓰는 비상 충전 같은 기능입니다 |
| 표·그래프·캡처를 더 잘 읽는다 | 기능 문서: 차트·도표·스크린샷 판독 정확도 향상 | 엑셀 캡처나 매출 그래프를 올리면 숫자를 더 정확히 읽습니다 |
설정 하나도 바뀌었습니다.
"The default effort is medium." — Anthropic, What's new in Claude Opus 5.5
💬 쉽게 말하면 · 기본값이 「적당히 생각하고 답하기」로 바뀌었습니다. 더 깊게 고민한 답이 필요하면 생각 강도를 올리면 됩니다. 오퍼스 5는 기본값이 한 단계 높은 「깊게」였습니다.
그래도 페이블이 필요한 순간
그렇다고 페이블이 필요 없어진 것은 아닙니다. Anthropic 공식 안내는 역할을 이렇게 나눕니다.
-
오퍼스 5.5 · 대부분의 일. 긴 코딩, 문서 작업, 컴퓨터 조작
-
페이블 5.1 · 몇 시간씩 이어지는 초대형 작업, 여러 단계의 심층 조사, 분석을 끝까지 문서·표·발표자료로 완성하는 일
그리고 순서를 권합니다. 먼저 오퍼스 5.5로 해 보고, 생각 강도를 가장 높게 올려도 부족할 때 페이블로 옮기라는 것입니다.
"Most workloads start with Claude Opus 5.5." — Anthropic, Choosing the right model
💬 쉽게 말하면 · 공식 추천도 「일단 오퍼스 5.5부터」입니다.
그래서 저는 이렇게 고릅니다
제가 마케팅을 하면서 늘 보는 장면이 있습니다. 만드는 쪽은 점수를 자랑하고, 쓰는 쪽은 "그래서 내 일에 맞아?"를 묻습니다. 모델 고르기도 똑같습니다. 제일 높은 점수가 아니라 내 일에 맞는 모델이 정답입니다.
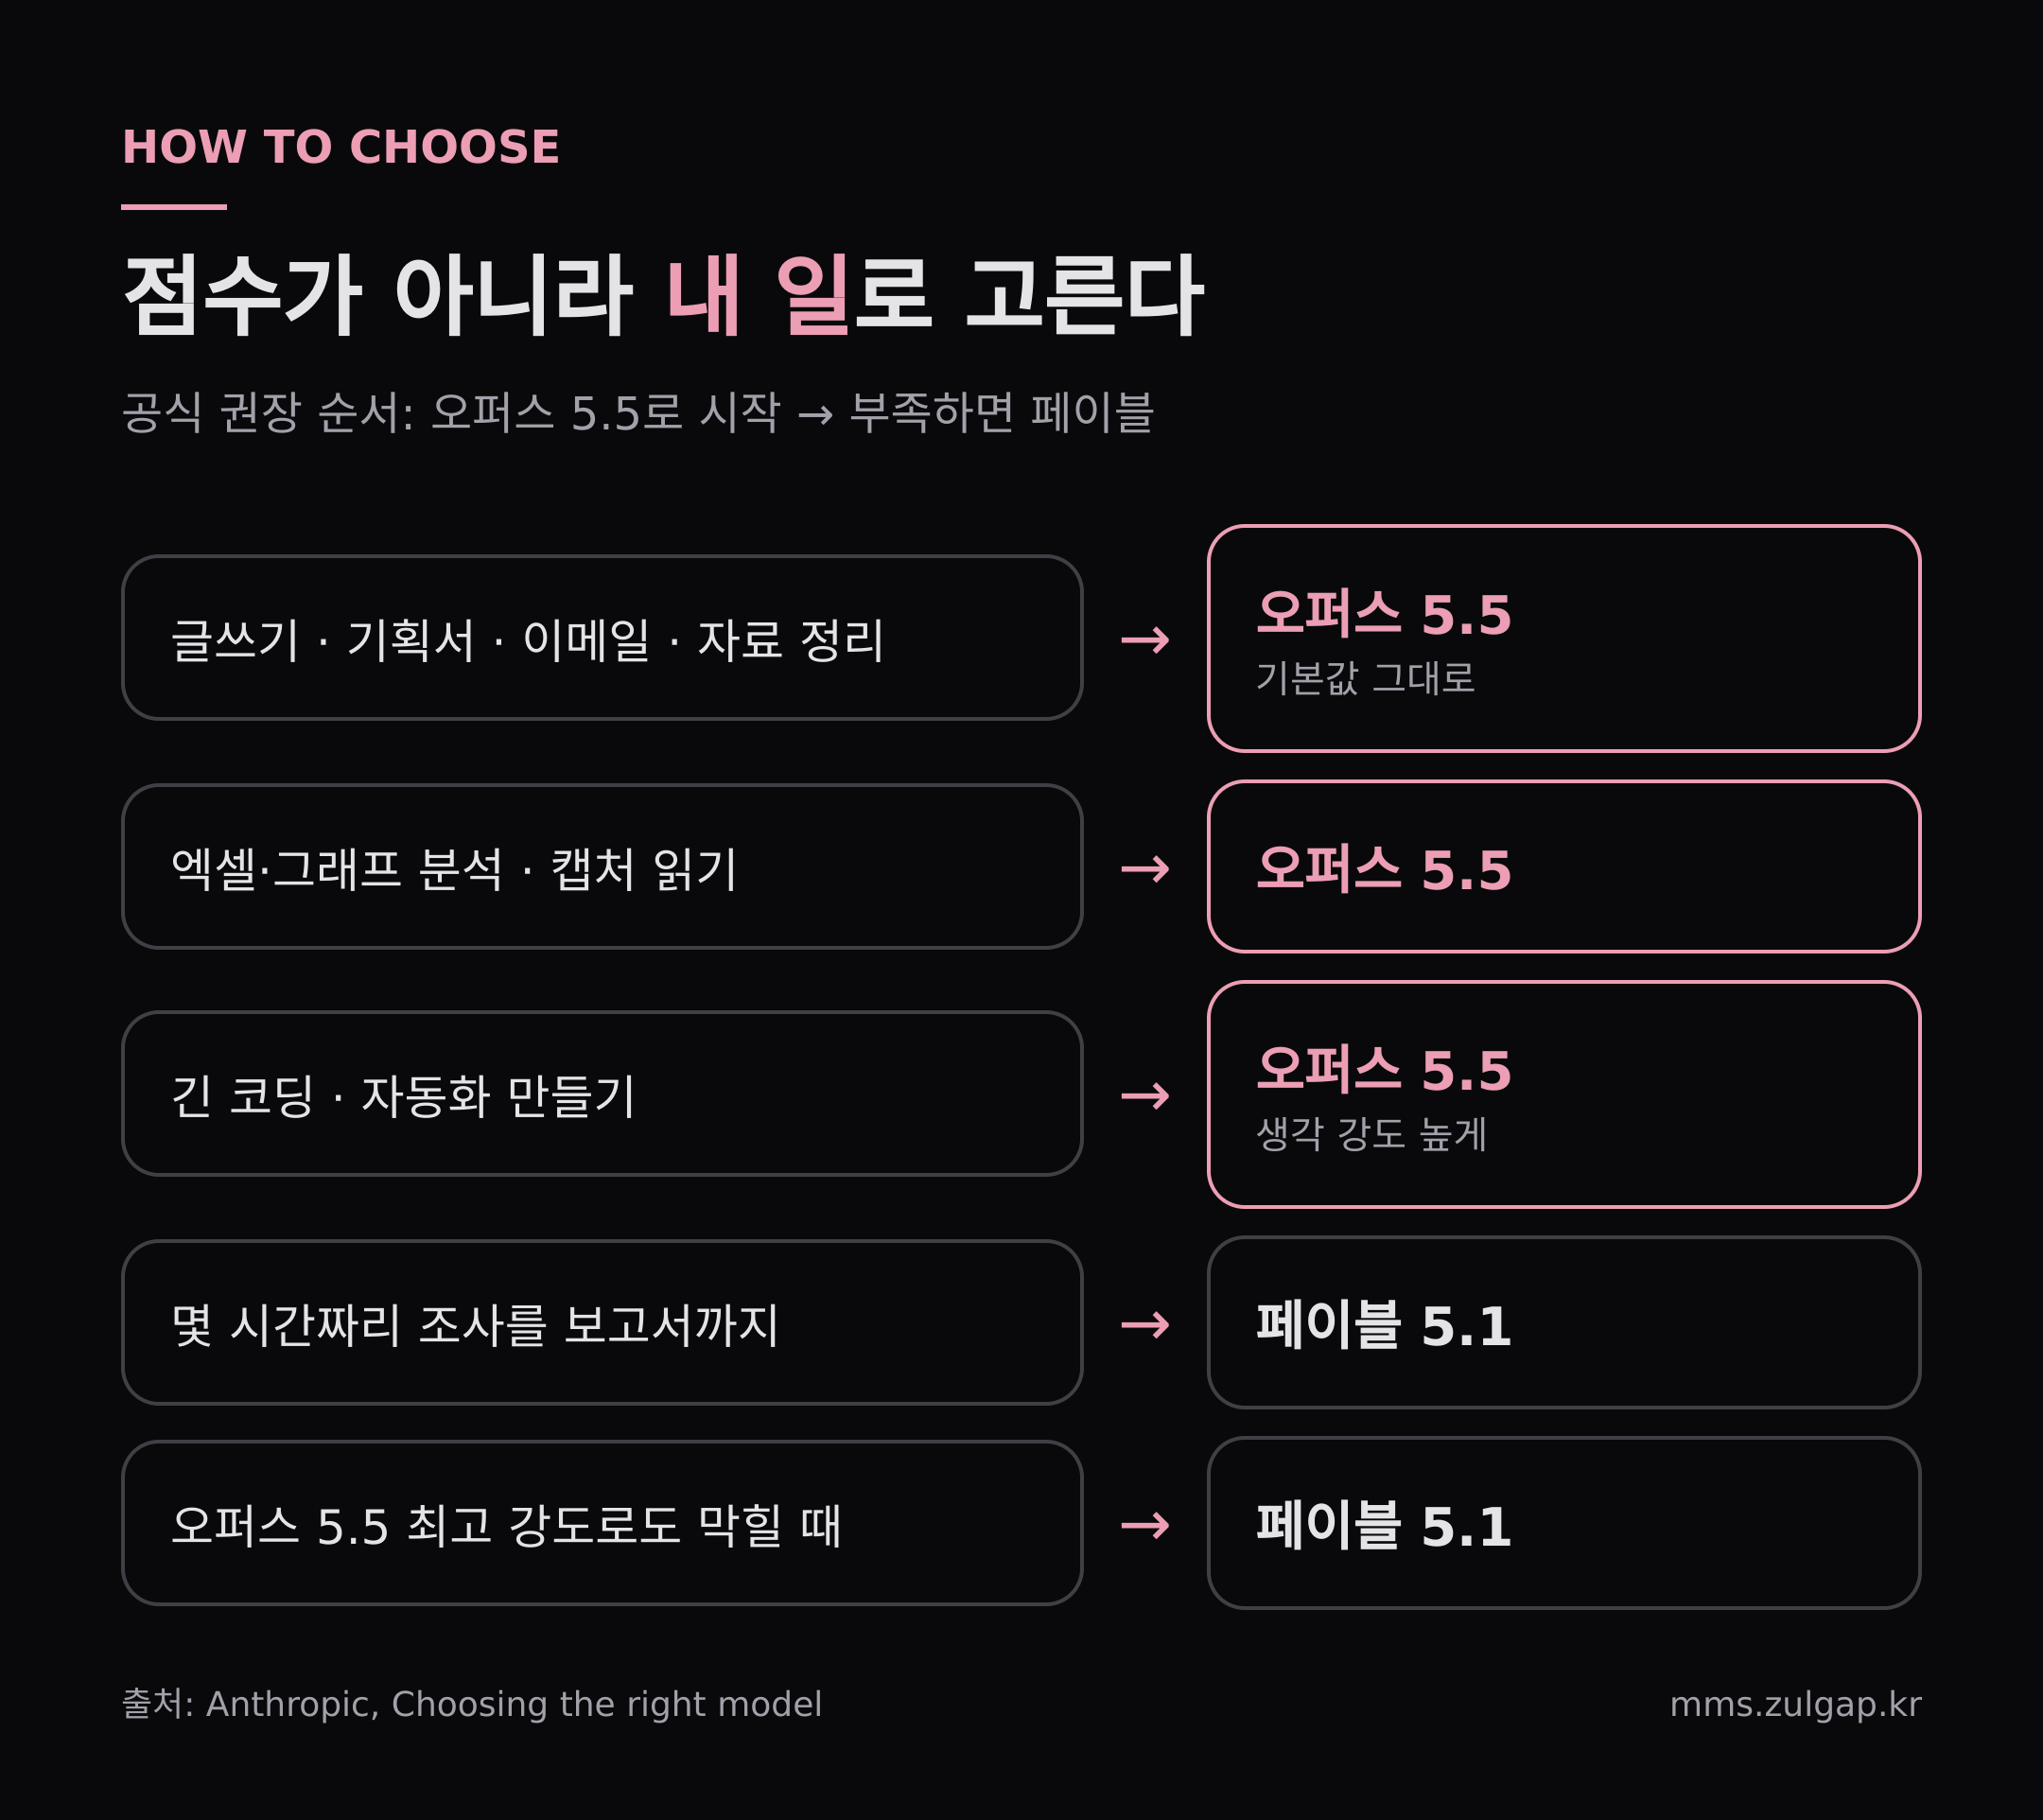
| 내 일이 이렇다면 | 이 모델로 |
|---|---|
| 글쓰기, 기획서, 이메일, 자료 정리 | 오퍼스 5.5 (기본값 그대로) |
| 엑셀·그래프 분석, 캡처 읽기 | 오퍼스 5.5 |
| 긴 코딩, 자동화 만들기 | 오퍼스 5.5 (생각 강도 높게) |
| 몇 시간 걸리는 조사를 보고서까지 완성 | 페이블 5.1 |
| 오퍼스 5.5를 최고 강도로 돌려도 막힐 때 | 페이블 5.1 |
제목의 질문에 답하면 이렇습니다. 대부분의 사장님은 이제 페이블 값을 안 내셔도 됩니다. 일단 클로드 오퍼스 5.5를 기본값으로 쓰시고, 막히는 일이 생기면 그때 페이블을 꺼내세요. 그게 돈도 시간도 가장 덜 드는 순서입니다.
모델만큼 중요한 게 AI가 우리 회사를 알아보게 만드는 일입니다. 이 부분은 AI 검색에서 우리 회사 이름이 안 나옵니다 — 무엇을 바꿔야 나오나에 정리해 두었고, 손님 질문에 답하는 글이 왜 AI에 인용되는지는 AI SEO, 새로 배울 게 아닙니다 — 손님 질문에 답한 글이 AI에 인용됩니다에서 이어서 보실 수 있습니다.
자주 묻는 질문
클로드 Pro 요금제에서도 오퍼스 5.5를 쓸 수 있나요?
네. Pro, Max, Team, Enterprise 요금제에서 쓸 수 있고, 같은 발표에서 5시간 사용 한도도 올렸습니다.
오퍼스 5를 쓰고 있는데 꼭 바꿔야 하나요?
앱에서 쓰신다면 바꾸는 쪽이 이득입니다. 더 빠르고 시험 점수도 전부 높습니다. 개발자분이라면 사고 기능을 끌 수 없고, 도구를 강제로 부르는 설정이 막히는 등 바뀐 규칙이 있으니 공식 이전 안내를 먼저 확인하세요.
페이블은 언제 써야 하나요?
몇 시간씩 이어지는 초대형 작업, 조사부터 보고서 완성까지 한 번에 맡기는 일, 그리고 오퍼스 5.5를 가장 높은 강도로 돌려도 부족할 때입니다.
가격 차이는 정확히 얼마인가요?
100만 토큰당 입력 기준으로 오퍼스 5.5가 4달러, 페이블 5.1이 10달러입니다. 출력은 20달러와 50달러입니다. 페이블이 두 배 반입니다.
참고 자료
-
Anthropic, Introducing Claude Opus 5.5 (2026-09-22)
-
Anthropic, Models overview
-
Anthropic, What's new in Claude Opus 5.5
-
Anthropic, Choosing the right model